• Integrated Circuit Design - Chia sẻ kiến thức về vi mạch

    Integrated Circuit Design - Chia sẻ kiến thức về vi mạch

    Vi mạch và Ứng dụng

  • Integrated Circuit Design - Chia sẻ kiến thức về vi mạch

    Integrated Circuit Design - Chia sẻ kiến thức về vi mạch

    Vi mạch và Ứng dụng

  • Integrated Circuit Design - Chia sẻ kiến thức về vi mạch

    Integrated Circuit Design - Chia sẻ kiến thức về vi mạch

    Vi mạch và Ứng dụng

Thứ Tư, 30 tháng 9, 2026

AI Flow VLSIT: Từ đặc tả phần cứng đến RTL và cách xây dựng agent chuyên biệt

Tóm tắt. VLSIT tổ chức quy trình hỗ trợ thiết kế RTL bằng mô hình ngôn ngữ lớn (LLM): từ đặc tả phần cứng, phân rã yêu cầu và cấu hình đến sinh RTL, testbench, assertion SystemVerilog (SVA), mô phỏng, kiểm thử đột biến (mutation testing) và tài liệu. Trọng tâm là phối hợp chỉ dẫn theo vai trò với artifact có cấu trúc, công cụ EDA và các điểm kỹ sư rà soát. Bài viết phân tích luồng này, xác định ranh giới tự động hóa và trình bày nguyên lý tạo agent chuyên biệt có phạm vi, hợp đồng đầu vào/đầu ra, tiêu chí hoàn tất và điều kiện dừng rõ ràng.

1. Mục tiêu và phạm vi phân tích

Bài viết xem VLSIT như một nguyên mẫu kỹ thuật cho quy trình thiết kế và kiểm chứng RTL có AI hỗ trợ. Phân tích tập trung vào kiến trúc các vai trò, luồng artifact, mức tự động hóa, cách tạo agent chuyên biệt và điều kiện cần để đánh giá kết quả. Đây là phân tích thiết kế quy trình, không phải báo cáo benchmark độc lập: các ví dụ và số liệu được đọc từ những lần chạy đã lưu, không được chạy lại trong một môi trường EDA mới. Vì vậy, chúng giúp minh họa cách vận hành chứ không thay thế regression có thể tái lập, chứng minh hình thức, phân tích timing tĩnh hay sign-off ASIC [1].

Mạch lập luận của bài đi từ ranh giới giữa LLM và công cụ thiết kế, sang cách các phase trao đổi dữ liệu; từ đó mới đánh giá phần nào có thể tự động hóa, vai trò nào nên tách thành agent và cách vận hành flow trên một IP cụ thể.

2. Khái niệm AI flow và ranh giới chức năng

VLSIT không phải một bộ trọng số LLM, pipeline huấn luyện/tinh chỉnh mô hình, hệ thống tăng cường truy xuất tri thức hay backend gọi API độc lập. Mô hình ngôn ngữ được cung cấp bởi môi trường chạy như Claude Code hoặc Codex CLI. Phần quy trình gồm chỉ dẫn theo vai trò, quy tắc RTL, lược đồ dữ liệu, script và artifact dự án; LLM dùng chúng để thực hiện từng công việc trong vòng đời thiết kế [1].

Do đó, “AI flow” ở đây là một quy trình kỹ thuật được điều khiển bằng chỉ dẫn cho agent, chứ không phải một công cụ EDA mới. Mỗi vai trò nhận một nhóm đầu vào, thực hiện nhiệm vụ giới hạn, ghi artifact ra project rồi bàn giao cho phase kế tiếp. LLM có thể phân tích và tạo mã, nhưng không thể tự biến suy luận thành bằng chứng thực thi; lint, synthesis và mô phỏng phải do Verilator, Yosys hoặc simulator chạy trên thiết kế thật.

Ba lớp kiến trúc

  1. Lớp chỉ dẫn và điều phối: 9 Claude Code commands dưới .claude/commands/ và 9 Codex CLI project skills dưới .agents/skills/. Mỗi phase có thể được gọi riêng; /autoflow hoặc skill autoflow mô tả trình tự tổng thể.
  2. Lớp dữ liệu và truy vết: đặc tả, JSON artifacts, JSON Schema và Requirement Traceability Matrix (RTM). Chúng giúp các phase trao đổi một baseline cụ thể, thay vì dựa hoàn toàn vào lịch sử hội thoại.
  3. Lớp thiết kế và bằng chứng: SystemVerilog, script Bash/Yosys, lint, synthesis, simulation và các log/báo cáo do công cụ tạo ra.

Ba lớp này tạo thành một chu trình: chỉ dẫn định hình công việc của LLM, artifact lưu trạng thái thiết kế, còn EDA tạo bằng chứng từ mã và cấu hình đã lưu. Việc phân lớp giúp phân biệt rõ nơi sinh ra kết quả với nơi kiểm tra kết quả.

Lớp kiến trúcThành phầnVai trò trong flow
Điều phối AILLM, command và project skillĐọc đầu vào, thực hiện phase, chuyển tiếp theo chỉ dẫn.
Dữ liệu và truy vếtĐặc tả, JSON Schema, artifact và RTMLưu baseline, cấu hình và quan hệ giữa requirement với bằng chứng.
Thiết kế và kiểm traRTL, SVA, testbench, EDA và logTạo thiết kế, chạy kiểm tra thực thi và ghi kết quả.

Hình 1. AI, prompt, project artifact và EDA có vai trò khác nhau. Prompt hướng dẫn; artifact lưu trạng thái; EDA tạo bằng chứng thực thi.

Slash command và skill không tự thân là workflow engine cưỡng chế mọi điều kiện. Thứ tự phase, điểm dừng và cách cập nhật artifact hiện được mô tả trong các chỉ dẫn; tính nhất quán vì vậy phụ thuộc vào cách agent thực hiện và việc đối chiếu với công cụ. Một dòng “PASS” trong phần tóm tắt chỉ là kết luận đáng tin khi có lệnh và log tương ứng để kiểm tra [1, 3, 6].

3. Luồng từ yêu cầu đến tài liệu

Khi đã tách được ba lớp kiến trúc, có thể theo dõi cách dữ liệu đi qua hệ thống. Luồng bắt đầu từ đặc tả phần cứng hoặc mô tả bằng ngôn ngữ tự nhiên, sau đó chuyển thành yêu cầu có mã định danh, cấu hình, RTL, test và bằng chứng verification [2].

Phase Vai trò chính Artifact hoặc bằng chứng cần xem
0 — Viết spec (tùy chọn) spec_writer chuyển mô tả ban đầu thành bản đặc tả có cấu trúc hơn. spec/<ip_name>_spec.md
1 — Phân tích spec spec_parser tách requirement, gán REQ-ID, đánh dấu mơ hồ, ánh xạ module/parameter và gợi ý property. schemas/structured_spec.json; review tại Gate 1
2 — Chốt cấu hình config_ui chọn parameter và kiểm tra ràng buộc. Đây là tương tác trong hội thoại, không phải GUI riêng. schemas/final_config.json; Gate 2
3a — Sinh RTL rtl_generator tạo SystemVerilog theo spec, cấu hình và coding rules; chạy lint, rồi synthesis khi môi trường sẵn sàng. src/rtl/, file list và synth_report.json
4 — Sinh testbench tb_generator tạo test plan và testbench SystemVerilog. src/tb/, selected_testplan.json; kiểm tra compile
3b — Sinh assertions sva_generator tạo SVA, bind và cập nhật traceability; cần đánh giá ý nghĩa property và vacuity. src/sva/, rtm.json; review tại Gate 3b
5 — Verification verification nối testbench và SVA với compile, simulation, mutation khi có công cụ phù hợp, cập nhật các verification gap. Log thực thi, verification_report.json, RTM; review tại Gate 5
6 — Tài liệu spec_pdf_generator tổng hợp artifact và RTL thành tài liệu Markdown/PDF. docs/specification.md, PDF nếu chuyển đổi thành công
Trình tựPhase / vai tròĐầu ra và cổng review
1Phân tích đặc tảstructured_spec.json; Gate 1 do kỹ sư review.
2Chốt cấu hìnhfinal_config.json; Gate 2 có thể tự xác nhận khi đạt điều kiện.
3a và 4Sinh RTL; sinh testbenchRTL, lint/synthesis, test plan và compile check; hai phase được chạy tuần tự trong một session.
3bSinh SVAAssertion, bind, RTM; Gate 3b review ý nghĩa property và vacuity.
5VerificationCompile, simulation, mutation khi có tool; Gate 5 review log và gap.
6Tổng hợp tài liệuMarkdown/PDF sau khi kết quả đã qua review.

Hình 2. Trình tự phase và các cổng rà soát. Gate 2 và Gate 4 có thể tự xác nhận trong autoflow khi đạt điều kiện; Gate 1, Gate 3b và Gate 5 yêu cầu kỹ sư xem xét.

Gate là gì và vì sao cần giữ lại?

  • Gate 1 — baseline yêu cầu: kỹ sư xác nhận yêu cầu đã được tách đúng, không còn quyết định mơ hồ chưa xử lý và mapping sang module/parameter là hợp lý. Nếu lỗi ở đây, mọi artifact sau đó có thể nhất quán về cú pháp nhưng sai chức năng.
  • Gate 2 — baseline cấu hình: autoflow có thể chọn giá trị mặc định, trừ khi có override từ spec hoặc hội thoại; có thể tự xác nhận khi không lỗi. Việc này thuận tiện nhưng cần đưa giá trị cấu hình quan trọng vào spec, tránh dựa vào mặc định mà người dùng không chủ ý.
  • Gate 3b — review property: con người cần xác nhận assertion diễn tả đúng intent, bind đúng tín hiệu và không bị vacuous do stimulus không kích hoạt điều kiện. Compile pass chỉ chứng minh cú pháp/khả năng biên dịch, không chứng minh property đúng.
  • Gate 4 — testbench: theo autoflow, có thể tự xác nhận nếu compile check pass. Compile testbench không đồng nghĩa test có kiểm tra hành vi đủ mạnh.
  • Gate 5 — verification/sign-off: kỹ sư cần đọc kết quả từng test, xác nhận SVA có thực sự chạy, xem mutation và các requirement còn thiếu bằng chứng. Flow khóa sign-off của requirement tương ứng nếu mutation score dưới 85%; trường hợp N/A có thể được chính sách cho phép nhưng không phải mutation pass. Gate 5 được duyệt cũng không đồng nghĩa mọi REQ-ID đã sign-off [2, 5].

RTM: trục chính của khả năng truy vết

RTM kết nối chuỗi:

REQ-ID → khối/file RTL → SVA đã review → test case được chọn → kết quả chạy → trạng thái sign-off

Khi có yêu cầu thay đổi, chuỗi này hỗ trợ trả lời: requirement nào bị ảnh hưởng? Có RTL implement không? Có assertion kiểm soát không? Có test kích hoạt và bằng chứng pass không? Vẫn còn requirement pending/locked nào? Đây là giá trị kỹ thuật đáng chú ý hơn việc chỉ sinh một tập file RTL. Tuy nhiên RTM chỉ hữu ích nếu mapping được kiểm tra và trạng thái không bị sao chép từ một lần chạy cũ. Một JSON hợp lệ về cấu trúc chưa đảm bảo nội dung đúng về ngữ nghĩa.

RTM vì thế là cầu nối giữa việc sinh thiết kế và việc quyết định có đủ bằng chứng hay chưa. Để hiểu vai trò thực tế của AI, cần tách rõ những thao tác có thể giao cho agent với các điểm vẫn cần con người phê duyệt.

4. Ranh giới của tự động hóa

Những thao tác có thể tự động hóa

Autoflow có thể bắt đầu từ file đặc tả có sẵn hoặc từ mô tả thiết kế (--describe). Sau đó, agent gọi các phase theo thứ tự, đọc và ghi artifact, trình bày tóm tắt, dùng giá trị mặc định khi chưa có override, và tiếp tục từ phase đã chọn dựa trên trạng thái đã lưu. Các điểm resume được hỗ trợ gồm phase3b, phase5 và phase6 [3, 6].

Khi thiếu đầu vào hoặc gặp lỗi nghiêm trọng, flow cần dừng, báo lint/compile/simulation thất bại và không chuyển tiếp nếu điều kiện chưa đạt. Khả năng tạo mã, chạy lệnh và đọc log còn phụ thuộc quyền truy cập project, shell, toolchain, thư viện PDK và license trên máy chạy.

“Automatic” không có nghĩa là thiết kế tự duyệt

Có thể tự động hóa trong flow Vẫn cần kỹ sư quyết định hoặc kiểm tra
Soạn draft spec, phân tích thành requirement có mã định danh Tính đúng, đầy đủ và không mơ hồ của spec
Đọc parameter và tạo file cấu hình Giá trị cấu hình có phù hợp mục tiêu sản phẩm hay không
Sinh RTL/SVA/testbench theo prompt và coding rules Ý nghĩa chức năng, giao thức, corner case và chất lượng stimulus
Gọi lint, synthesis, compile, simulation nếu tool có sẵn Log có phản ánh đúng baseline; phạm vi kiểm chứng có đủ hay không
Cập nhật JSON/RTM và tổng hợp tài liệu Chấp nhận gate, ký sign-off, quyết định xử lý verification gap

RTL và testbench là hai đầu ra có thể phát triển độc lập sau Gate 2, nhưng autoflow hiện gọi Phase 3a trước rồi đến Phase 4 trong cùng session. Không có scheduler để thực thi đồng thời; “độc lập” ở đây mô tả quan hệ công việc, không phải bảo đảm về chạy song song [1, 3].

Ranh giới này cũng giúp xác định đúng vai trò của agent: tự động hóa được những thao tác có đầu vào và tiêu chí rõ, còn quyết định về yêu cầu, ngữ nghĩa property và sign-off cần người chịu trách nhiệm xem xét.

5. Nguyên lý tạo agent riêng trong flow này

5.1 Agent chuyên biệt là một vai trò có hợp đồng rõ ràng

Trong VLSIT, mỗi vai trò được hiện thực hóa bằng một bộ chỉ dẫn gắn với môi trường chạy:

  • Với Claude Code, mỗi command là một file Markdown dưới .claude/commands/, ví dụ rtl_generator.md.
  • Với Codex CLI, mỗi project skill là thư mục có file SKILL.md dưới .agents/skills/<skill-name>/. Phần đầu file có metadata name và description, sau đó là hướng dẫn mà agent đọc và làm theo. Bộ hiện có 9 skill, tương ứng với 9 command phase của Claude Code.
  • Với autoflow, vai trò điều phối gọi/đọc các phase khác và dựa vào artifact đã lưu để xác định trạng thái tiếp theo.

Command và skill là cấu hình vai trò bên trong host agent. Tạo một skill không tự sinh ra process LLM độc lập, model riêng hay năng lực chạy đồng thời. Các phase chuyển giao bằng cách đọc skill kế tiếp và trao đổi qua artifact; muốn chạy song song cần có cơ chế điều phối thực sự, không chỉ chia prompt [1, 6].

Vai tròTrách nhiệmBàn giao
Agent điều phốiTheo dõi phase, dependency, trạng thái và gate.Chỉ định phase kế tiếp dựa trên artifact.
Agent phân tích spec / cấu hìnhTách requirement, ambiguity và parameter.structured_spec.json, final_config.json.
Agent RTL / testbench / SVATạo các sản phẩm thiết kế và verification theo phạm vi riêng.RTL, test plan, testbench, assertion và RTM.
Agent verificationChạy công cụ sẵn có, tổng hợp kết quả và gap.Log và verification report.

Điểm kiểm soát: kỹ sư duyệt yêu cầu, property và bằng chứng sign-off. Việc chia vai trò không đồng nghĩa các agent chạy đồng thời.

Hình 3. Mô hình vai trò: agent điều phối giao việc cho các vai trò chuyên biệt, artifact giữ trạng thái giữa phase và kỹ sư duyệt quyết định quan trọng. Các vai trò không mặc nhiên là những tiến trình LLM chạy đồng thời.

5.2 Bảy nguyên tắc để tạo một agent hữu dụng

  1. Đặt một nhiệm vụ hẹp và có lý do tồn tại. Ví dụ “kiểm tra tính nhất quán giữa port RTL với interface trong spec” dễ đánh giá hơn “thiết kế IP hoàn chỉnh”.
  2. Khai báo đầu vào và nguồn sự thật. Nêu rõ agent phải đọc file nào, phiên bản nào là chuẩn và điều gì được xem là thiếu. Khi spec và RTL mâu thuẫn, agent nên báo mâu thuẫn thay vì tự chọn một phía.
  3. Định nghĩa đầu ra có thể kiểm tra. Ghi tên file, schema/trường bắt buộc, format summary và cách liên kết finding với REQ-ID. Tránh output chỉ là một đoạn nhận xét tự do nếu bước sau cần tiêu thụ dữ liệu.
  4. Nêu quyền và giới hạn thao tác. Agent có được sửa RTL không, hay chỉ đọc và báo cáo? Có được chạy lệnh nào? Khi input không rõ, cần dừng hay được dùng giả định nào? Quy định này hạn chế việc agent âm thầm mở rộng phạm vi.
  5. Viết điều kiện đạt và điều kiện dừng rõ ràng. Ví dụ: mọi requirement interface được map; lint phải thực sự chạy; tool không có thì kết quả là “not run”, không phải pass; lỗi blocker thì không chuyển phase.
  6. Thiết kế phase để nối với flow. Mô tả phase trước/sau, artifact cần đọc/ghi và ảnh hưởng của việc sửa input. Autoflow nên điều phối phase, còn mỗi agent chuyên trách nên giữ một nhiệm vụ duy nhất.
  7. Tạo khả năng truy vết và resume. Ghi REQ-ID, baseline/phiên bản, lệnh và log tương ứng; không tái sử dụng approval hoặc báo cáo cũ nếu spec/config đã thay đổi.

Có thể nhớ công thức:

Vai trò + đầu vào chuẩn + hành động cho phép + đầu ra có cấu trúc + tiêu chí đạt + điều kiện dừng + bàn giao

5.3 Mẫu skill minh họa: agent rà soát interface

Ví dụ dưới đây minh họa cách thu hẹp nhiệm vụ thành một agent có thể đánh giá được. Agent chỉ đọc và phát hiện sai khác giữa đặc tả giao tiếp với khai báo port RTL; nó không tự sửa thiết kế.

---
name: source-command-interface-auditor
description: "Review interface consistency between an approved hardware specification and SystemVerilog RTL."
---
# Interface Auditor

## Mục tiêu
Đối chiếu interface của module với spec đã được duyệt; không sinh hoặc sửa RTL.

## Đầu vào bắt buộc
- schemas/structured_spec.json
- schemas/final_config.json
- Danh sách file RTL/top module của baseline đang review
- REQ-ID liên quan nếu được cung cấp

## Thực hiện
1. Xác định spec và cấu hình thuộc cùng baseline với RTL.
2. Trích tên, hướng, độ rộng và nhóm clock/reset của từng port.
3. Đối chiếu từng trường với yêu cầu nguồn.
4. Ghi finding có mức độ, file/port, REQ-ID, bằng chứng và cách tái hiện.
5. Không suy đoán giá trị còn thiếu; ghi là unresolved và dừng nếu ảnh hưởng đến kết luận.

## Đầu ra
- reports/interface_audit.md: tóm tắt, findings, unresolved items và baseline
- schemas/interface_audit.json: status, checked_ports, findings, source_files

## Tiêu chí hoàn tất
- Mọi port top-level thuộc phạm vi đã được kiểm tra.
- Tool/log chỉ được đánh dấu pass nếu thực sự đã chạy và đọc kết quả.
- Nếu spec thiếu hoặc baseline không khớp, kết quả là blocked, không phải pass.

## Bàn giao
Chỉ đề xuất Gate review khi không còn finding blocker. Chờ kỹ sư quyết định mọi thay đổi thiết kế.

Ví dụ cho thấy nguyên lý cốt lõi: giới hạn agent vào một nhiệm vụ, xác định artifact đầu vào/đầu ra và yêu cầu nó giải thích bằng chứng. Vai trò đó có thể được đóng gói thành project skill của Codex CLI hoặc command Markdown của Claude Code; cách kích hoạt phụ thuộc môi trường chạy [1, 6].

5.4 Đưa agent mới vào autoflow

Tạo file skill hoặc command thôi chưa làm agent mới tự chạy. Để tích hợp đúng, cần thực hiện tuần tự:

  1. Chọn vị trí và tên rõ ràng. Với Codex CLI, tạo thư mục skill và SKILL.md có name, description cùng nội dung hướng dẫn. Với Claude Code, tạo command Markdown ở vị trí command mà project đang dùng.
  2. Xác định artifact contract. Thêm JSON Schema nếu đầu ra cần được phase sau tiêu thụ có kiểm tra trường. Chọn đường dẫn ổn định và mô tả owner của mỗi artifact.
  3. Viết hướng dẫn độc lập. Một skill phải có đủ ngữ cảnh để host agent biết lúc nào dùng, đọc gì, làm gì, tạo gì và báo gì nếu thiếu tool. Hạn chế phụ thuộc ngầm vào một cuộc hội thoại trước.
  4. Thêm phase vào orchestrator. Chỉ định phase chạy sau/before nào, gate nào bảo vệ bước đó, điều kiện được đi tiếp và cách resume. Nếu không sửa điều phối thì agent mới chỉ có thể gọi thủ công.
  5. Cập nhật điều phối và tài liệu dự án. Đăng ký phase mới trong orchestrator, preflight, sơ đồ và danh sách artifact để agent có thể được gọi đúng lúc.
  6. Rà soát tương thích IP. Các vai trò mẫu chứa giả định về module, tín hiệu, schema và môi trường EDA. Khi đổi IP, cập nhật đồng bộ mapping của parser, cấu hình, hierarchy RTL, SVA, test plan và tài liệu.
  7. Kiểm chứng bằng fixture nhỏ. Tạo spec thử có kết quả mong đợi; kiểm tra trường hợp đạt, thiếu input, mâu thuẫn, tool không sẵn sàng và resume sau khi input đổi. Lưu log để kỹ sư review. Điều phối chỉ đáng tin khi các điều kiện này có thể được kiểm tra, thay vì chỉ dựa vào lời khẳng định của agent.

Nguyên tắc thiết kế phù hợp là worker theo phase, orchestrator gọn: mỗi worker chịu trách nhiệm một loại suy luận hoặc sản phẩm; orchestrator giữ thứ tự, dependency, trạng thái và cổng duyệt. Một prompt quá lớn khó bảo trì; ngược lại, tách quá nhiều worker mà thiếu schema và gate dễ làm các vai trò ghi đè artifact hoặc lệch baseline.

Sau khi xác định hợp đồng của từng vai trò, bước tiếp theo là chuẩn bị môi trường và dữ liệu đầu vào để flow có thể chạy trên một thiết kế cụ thể.

6. Vận hành flow trên một IP cụ thể

6.1 Chuẩn bị

Flow cần môi trường Linux/Bash có Environment Modules và công cụ EDA. Trước khi chạy, kiểm tra sourceme.sh, phiên bản tool, đường dẫn PDK và module có sẵn trên máy. Verilator dùng cho lint, Yosys cho synthesis, thư viện GF180MCU Liberty cho technology mapping và simulator phù hợp cho kiểm chứng. VCS cần cài đặt và license riêng; một số đường chạy Icarus bỏ qua SVA. Script tạo PDF cần Python 3 và Matplotlib. Mọi giả định về đường dẫn và module phải khớp với host thực tế [1, 2].

Trên Windows, Bash script cần chạy trong môi trường Linux như WSL hoặc máy chủ EDA, không chạy trực tiếp trong PowerShell. Flow không tự cài EDA, cấp license hay tạo PDK; các thành phần này phải được chuẩn bị riêng.

Khi môi trường đã sẵn sàng, chất lượng đầu vào quyết định phần lớn mức độ ổn định của các phase sinh mã.

6.2 Chọn đầu vào và điều chỉnh cho IP mới

  1. Làm việc trên branch hoặc bản sao riêng để giữ snapshot tham khảo.
  2. Viết spec tại spec/<ip_name>_spec.md, mô tả interface, parameters, clock/reset, hành vi chức năng, timing và error behavior.
  3. Với IP mới, điều chỉnh parser mapping, module hierarchy, constraint/config, RTL rules, SVA, test plan và format tài liệu.
  4. Chuẩn bị JSON Schema tại đường dẫn mà phase sử dụng. Phân biệt rõ file đầu vào, template và artifact được sinh ra, kể cả khi chúng có tên gần giống nhau.

Các template hiện có chứa giả định về cấu trúc IP và môi trường EDA cụ thể. Vì vậy, đổi spec thôi chưa đủ để áp dụng flow cho một thiết kế khác; cần rà soát các mapping, cấu hình, phân cấp module, property và test plan liên quan.

6.3 Chạy toàn bộ flow

Trong Claude Code, mở project root và nhập command trong hội thoại:

/autoflow spec/<ip_name>_spec.md

Nếu mới có mô tả thiết kế:

/autoflow --describe

Trong Codex CLI, gọi project skill trong phiên làm việc:

$source-command-autoflow
Dùng spec/<ip_name>_spec.md

Tên skill Codex khác cú pháp slash command Claude; không nhập chúng như lệnh Bash trong terminal. Để kiểm soát từng bước, gọi riêng các phase theo bảng ở mục 3. Sinh testbench trước khi review SVA giúp kỹ sư kiểm tra property trong bối cảnh stimulus dự kiến.

Nếu flow bị gián đoạn, có thể yêu cầu tiếp tục từ phase cần thiết hoặc dùng tham số --from. Trước khi resume, xác nhận spec, cấu hình, RTL và báo cáo thuộc cùng baseline. Thay đổi spec hoặc config có thể làm mất hiệu lực các bước sau; khi đó cần chạy lại các phase phụ thuộc thay vì giữ approval hay report cũ [2].

6.4 Những file cần đọc sau khi chạy

Thông thường nên xem:

  • schemas/structured_spec.json: requirement IDs, ambiguity và mapping.
  • schemas/final_config.json: parameter thực tế đã chốt.
  • src/rtl/ và schemas/synth_report.json: RTL, file list, lint/synthesis.
  • src/tb/ và schemas/selected_testplan.json: test plan, testbench, requirement coverage.
  • src/sva/, schemas/rtm.json, GATE3_REVIEW.md: assertions, mapping và vacuity review.
  • Log simulation/mutation và schemas/verification_report.json: bằng chứng thực chạy, failure và gap.
  • docs/specification.md/PDF: tài liệu tổng hợp.

Không xem file được sinh là thay thế log. Nếu một bước bị bỏ qua do thiếu tool, ghi rõ “not run” và không suy diễn thành pass.

7. Tính năng đáng chú ý

Khi một lần chạy tạo đủ artifact và log, giá trị của flow không chỉ nằm ở lượng mã sinh ra mà còn ở khả năng giải thích mã đó đáp ứng yêu cầu nào và đã được kiểm tra bằng cách nào.

7.1 Requirement traceability

REQ-ID được giữ xuyên qua spec, RTL, SVA, test case và verification status, cho phép đánh giá coverage theo yêu cầu thay vì chỉ đếm số module hoặc test.

7.2 Quy ước và kiểm tra nhất quán

Quy tắc RTL chuẩn hóa SystemVerilog-2012 synthesizable subset, cách đặt tên port/parameter/register/wire, reset active-low, module, assertion và coding pattern. Quy tắc chung giúp đầu ra dễ đọc và review hơn, nhưng cần được điều chỉnh theo chuẩn của IP đích [7].

7.3 Tách biệt sinh mã và kiểm chứng

Các vai trò RTL, SVA, testbench và verification có trách nhiệm riêng. Về nguyên tắc, điều này giúp tránh kết luận “RTL đúng vì chính prompt sinh RTL nói vậy”. Công cụ lint/simulation/mutation có thể cung cấp một phần bằng chứng bên ngoài LLM; độ mạnh phụ thuộc cấu hình và phạm vi test/property.

7.4 Resume và artifact tái sử dụng

Các artifact trong thư mục schema lưu trạng thái để flow tiếp tục sau gián đoạn. Cách này đáng tin hơn việc chỉ dựa vào lịch sử hội thoại, miễn là artifact thuộc cùng baseline và thay đổi input làm chạy lại đúng các phase phụ thuộc.

7.5 Có ví dụ thiết kế và snapshot

Hai snapshot minh họa cho các loại thiết kế khác nhau: lõi xử lý RV32IM và bộ chuyển đổi độ rộng dữ liệu AXI4-Stream. Downscaler chia beat theo thứ tự LSB-first và truyền TKEEP/TLAST; đây là chuyển độ rộng dữ liệu, không phải giảm độ phân giải ảnh. Số liệu của mỗi snapshot chỉ phản ánh lần chạy tương ứng [1].

Những khả năng này hữu ích khi artifact được nối với bằng chứng có thể kiểm tra. Phần tiếp theo nêu giới hạn cần tính đến trước khi dùng kết quả cho quyết định kỹ thuật.

8. Giới hạn và rủi ro khi diễn giải kết quả

  1. Chưa phải sign-off sản xuất. Lint, synthesis mapping và simulation không tự chứng minh timing closure, CDC/RDC an toàn, physical implementation hoặc đầy đủ chức năng. Flow hiện chưa bao gồm STA, place-and-route hay quy trình sign-off đầy đủ [1].
  2. Evidence có thể thiếu hoặc lệch baseline. Một số log cuối cùng, mutation working files hoặc artifact cần để tái lập không có trong snapshot. Báo cáo JSON không thay thế log nguồn.
  3. SVA có thể compile nhưng không hữu ích. Assertion vacuous, bind sai tín hiệu hoặc stimulus không kích hoạt property đều có thể làm kết quả trông “sạch” mà không kiểm tra hành vi mong muốn.
  4. Pass count có thể che khuất test N/A. Cần đọc từng test case và điều kiện pass/fail; số TC tổng hợp không nói được mọi requirement đã được kiểm chứng.
  5. Chênh lệch giữa command, template, schema và ví dụ. Một số phiên bản chỉ dẫn, schema và snapshot chưa hoàn toàn đồng nhất; ví dụ synthesis cũ cũng có thể không phản ánh các cập nhật mới. Phần tự động mô tả RTL/TB độc lập nhưng trình tự thực thi trong một session là tuần tự. Trước khi chạy, cần chọn một baseline và rà soát tính nhất quán [1, 3].
  6. Giả định toolchain/PDK. sourceme.sh giả định module, Bash và đường dẫn PDK cụ thể; các snapshot có thể chứa đường dẫn tuyệt đối. Không nên xem script là gói cài đặt portable.
  7. Chưa xác định quyền sử dụng. Bản công khai được khảo sát không kèm file LICENSE; cần xác nhận quyền sử dụng và phân phối với chủ sở hữu, đồng thời tuân thủ license riêng của EDA/PDK [1].

Những giới hạn này không làm mất giá trị của khung quy trình; chúng xác định loại kết luận có thể rút ra từ artifact và loại quyết định vẫn cần kỹ sư chịu trách nhiệm. Các thuật ngữ dưới đây được dùng theo nghĩa đó.

9. Giải thích các thuật ngữ tiếng Anh

Bảng dưới đây giải nghĩa những cụm từ kỹ thuật tiếng Anh được giữ lại trong bài. Một số thuật ngữ có bản dịch ngắn, nhưng phần giải thích tập trung vào ý nghĩa trong quy trình thiết kế RTL.

Thuật ngữ Cách gọi tiếng Việt và ý nghĩa trong bài
AI flow / workflow Luồng công việc có AI hỗ trợ: chuỗi bước, điều kiện chuyển tiếp và người chịu trách nhiệm.
AI-assisted RTL Thiết kế RTL có AI hỗ trợ; AI giúp phân tích yêu cầu hoặc đề xuất mã, còn tính đúng phải được kiểm tra.
Agent Tác tử AI được giao một vai trò/nhiệm vụ. Một vai trò có thể được mô tả bằng prompt hoặc skill mà không cần là một tiến trình AI riêng.
LLM (Large Language Model) Mô hình ngôn ngữ lớn, sinh/diễn giải văn bản và mã dựa trên ngữ cảnh được cung cấp.
Prompt Chỉ dẫn đầu vào cho mô hình, nêu mục tiêu, ngữ cảnh và cách thực hiện.
Slash command Lệnh bắt đầu bằng dấu gạch chéo, được nhập trong Claude Code để gọi một quy trình chỉ dẫn. Đây không phải lệnh Bash.
Project skill Bộ hướng dẫn theo vai trò đặt trong dự án để Codex CLI biết khi nào và cách thực hiện một nhiệm vụ.
Orchestrator Bộ điều phối: xác định thứ tự phase, dependency, trạng thái và các điểm duyệt. Trong VLSIT, autoflow đảm nhiệm vai trò này bằng cách hướng dẫn agent đi qua các phase.
RTL (Register-Transfer Level) Mô tả phần cứng ở mức thanh ghi và luồng dữ liệu; thường được viết bằng Verilog/SystemVerilog để tổng hợp thành mạch.
Specification / spec Đặc tả: mô tả có cấu trúc về chức năng, giao tiếp, tham số, clock/reset, timing và hành vi lỗi mà thiết kế phải đáp ứng.
Requirement Yêu cầu cụ thể, có thể truy vết và kiểm tra; trong flow được gán mã REQ-ID.
REQ-ID Mã định danh duy nhất của requirement, ví dụ REQ-001, dùng nối yêu cầu với RTL, assertion, test và kết quả.
Requirements traceability Truy vết yêu cầu: theo dõi một requirement xuyên suốt thiết kế và kiểm chứng.
RTM (Requirement Traceability Matrix) Ma trận truy vết yêu cầu; bảng/JSON liên kết requirement với RTL, SVA, test case, kết quả và sign-off.
Artifact Sản phẩm trung gian/đầu ra được lưu thành file, như JSON, RTL, testbench, log hoặc tài liệu.
Schema / JSON Schema Lược đồ dữ liệu; quy định trường, kiểu dữ liệu và cấu trúc mà một file JSON cần tuân theo.
Baseline Phiên bản chuẩn của spec, cấu hình, RTL và báo cáo được dùng làm mốc cho một lần chạy.
Phase Giai đoạn công việc có nhiệm vụ và đầu ra riêng trong flow.
Gate / review gate Cổng rà soát: điểm phải thỏa điều kiện hoặc được con người duyệt trước khi flow tiếp tục.
Human review Kỹ sư/con người rà soát kết quả và đưa ra quyết định; khác với việc agent tự tạo báo cáo.
Parameter / override Tham số cấu hình của thiết kế / giá trị ghi đè lên giá trị mặc định.
Interface / port Giao tiếp giữa các khối / một tín hiệu đầu vào, đầu ra hoặc hai chiều của module.
Testbench (TB) Môi trường kiểm thử mô phỏng: kích thích đầu vào, quan sát đầu ra và đánh giá kết quả của RTL.
Test plan Kế hoạch kiểm thử, mô tả các test case và requirement mà từng test dự kiến kiểm tra.
Compile / compile check Biên dịch / bước kiểm tra rằng source được công cụ chấp nhận về cú pháp và khả năng kết hợp. Compile thành công chưa chứng minh thiết kế đúng chức năng.
Lint Phân tích tĩnh để phát hiện lỗi cú pháp, vấn đề coding, độ rộng tín hiệu, latch ngoài ý muốn và các cảnh báo khác.
Synthesis Tổng hợp logic: chuyển RTL thành biểu diễn mạch/cell logic theo thư viện công nghệ và ràng buộc được cung cấp. Không thay thế STA hay physical design.
Simulation Mô phỏng hành vi thiết kế theo testbench và stimulus đã chọn. Kết quả chỉ bao phủ các tình huống thực sự được chạy.
SVA (SystemVerilog Assertions) Các khẳng định/thuộc tính viết bằng SystemVerilog để kiểm tra hành vi hoặc quan hệ theo thời gian của thiết kế.
Property Thuộc tính cần kiểm tra; ví dụ khi có request thì response phải xuất hiện trong một khoảng thời gian nhất định.
Bind Cơ chế gắn assertion hoặc checker vào module/instance thiết kế mà không nhất thiết sửa trực tiếp RTL của module đó.
Vacuity / vacuous property Assertion “đạt” một cách rỗng vì điều kiện kích hoạt không bao giờ xảy ra; do đó không có tình huống thực để kiểm tra property.
Verification Kiểm chứng: thu thập bằng chứng cho thấy thiết kế đáp ứng yêu cầu bằng test, assertion và phân tích kết quả.
Verification gap Khoảng trống kiểm chứng: requirement chưa có đủ test/property/bằng chứng hoặc chưa được sign-off.
Mutation testing Kiểm thử đột biến: cố ý tạo thay đổi nhỏ có lỗi trong thiết kế/mã rồi xem test có phát hiện được thay đổi sai đó không.
Mutation score Điểm/tỷ lệ đột biến bị test phát hiện trên tổng số đột biến hợp lệ đã thử; đây là chỉ số đánh giá độ nhạy của test, không phải phần trăm chức năng đúng.
Coverage Độ bao phủ kiểm thử: mức requirement, tình huống hoặc cấu trúc đã được test kích hoạt/kiểm tra. Có nhiều loại coverage và chúng không đồng nghĩa với nhau.
Sign-off Phê duyệt chính thức rằng một hạng mục đáp ứng tiêu chí đã định; không nên ký chỉ dựa trên summary do AI viết.
Regression Chạy lại tập kiểm thử sau khi thay đổi để kiểm tra rằng hành vi đã đúng trước đó không bị hỏng.
Formal proof / formal verification Chứng minh hoặc kiểm chứng hình thức bằng phương pháp toán học trên mô hình và giả thiết đã khai báo; mạnh hơn mô phỏng ở một số phạm vi nhưng phụ thuộc tính đúng của model/assumptions.
STA (Static Timing Analysis) Phân tích timing tĩnh: kiểm tra đường truyền tín hiệu so với ràng buộc thời gian/clock mà không cần mô phỏng vector.
CDC / RDC Kiểm tra tín hiệu đi qua miền clock khác nhau / miền reset khác nhau, nhằm tìm nguy cơ đồng bộ hoặc phục hồi/reset không an toàn.
PDK (Process Design Kit) Bộ dữ liệu công nghệ bán dẫn, gồm mô hình và thư viện cần cho thiết kế/kiểm tra theo một tiến trình cụ thể.
Liberty library File thư viện mô tả đặc tính cell chuẩn, như hàm logic, timing và công suất, dùng trong synthesis và phân tích liên quan.
Process corner Góc công nghệ/điện áp/nhiệt độ (ví dụ TT hoặc SS) dùng để đánh giá đặc tính cell trong điều kiện khác nhau.
Timing closure Đạt các ràng buộc timing sau các bước thiết kế vật lý và phân tích; chỉ chạy synthesis chưa chứng minh đã timing closure.
IP (Intellectual Property) Khối thiết kế phần cứng có thể tái sử dụng, như bộ xử lý, bộ điều khiển hoặc khối giao tiếp.
Toolchain Bộ công cụ và phiên bản phối hợp để thực hiện lint, synthesis, simulation và xử lý artifact.
Environment Modules Cơ chế trên máy Linux/HPC để nạp và chuyển phiên bản công cụ/thư viện vào môi trường làm việc.
Scheduler Bộ lập lịch điều phối công việc đồng thời hoặc theo tài nguyên. VLSIT hiện thực hiện các phase tuần tự trong một session, chưa có scheduler chạy chúng đồng thời.
Resume Tiếp tục flow từ một phase sau khi gián đoạn, dựa trên artifact đã lưu và baseline còn phù hợp.
LSB-first Truyền/xử lý phần bit ít quan trọng nhất trước; trong ví dụ downscaler, đây là thứ tự tách các lát dữ liệu.
TKEEP / TLAST Tín hiệu AXI4-Stream: TKEEP đánh dấu byte hợp lệ trong beat; TLAST đánh dấu beat cuối của một packet/frame.
EDA (Electronic Design Automation) Công cụ tự động hóa thiết kế điện tử, gồm lint, tổng hợp, mô phỏng và các bước phân tích thiết kế chip.
Engineering prototype Nguyên mẫu kỹ thuật dùng để thử nghiệm quy trình/ý tưởng; chưa đồng nghĩa sản phẩm đã hoàn thiện hoặc sign-off.
Snapshot Bản chụp artifact/log tại một thời điểm chạy; không mặc nhiên là kết quả có thể tái lập hoặc baseline hiện hành.
RAG (Retrieval-Augmented Generation) Sinh nội dung có tăng cường truy xuất: tìm tài liệu liên quan rồi đưa vào ngữ cảnh của mô hình trước khi tạo câu trả lời.
Fine-tuning Tinh chỉnh mô hình bằng dữ liệu bổ sung để thay đổi khả năng/hành vi; đây không phải thành phần của kiến trúc VLSIT đang phân tích.
Backend / API Dịch vụ phía máy chủ / giao diện lập trình để phần mềm gửi yêu cầu và nhận kết quả từ một dịch vụ khác.

10. Kết luận

VLSIT đưa ra một khung thực hành để đưa LLM vào chuỗi công việc RTL: chia nhiệm vụ thành phase, chuẩn hóa quy tắc coding, lưu artifact trung gian, duy trì RTM và giữ các điểm kỹ sư review. Giá trị chính nằm ở cách tổ chức quy trình và truy vết yêu cầu; việc sinh mã tự động không tự tạo ra một model RTL độc lập hay bảo đảm sign-off.

Khi áp dụng, prompt/skill định nghĩa cách agent hành động; JSON/RTM và log tạo hợp đồng dữ liệu và bằng chứng giữa các bước. Một agent riêng nên bắt đầu từ nhiệm vụ nhỏ, input chuẩn, output kiểm tra được, quyền thao tác rõ, tiêu chí đạt và điều kiện dừng; sau đó mới được tích hợp vào orchestrator. Kỹ sư giữ trách nhiệm xác nhận đặc tả, ngữ nghĩa assertion, mức bao phủ verification và sign-off cuối.

Tài liệu tham khảo

  1. VLSIT_RTL_Generator_AI_Model — README
  2. Hướng dẫn sử dụng — guideline.md
  3. Prompt điều phối — autoflow.md
  4. RTL Generator prompt
  5. Verification prompt
  6. Codex CLI autoflow skill
  7. Quy tắc RTL — rtl_rule.md

Tác giả: Lê Đại Quốc, Lê Trường Thịnh, Lương Triển Thắng, Nguyễn Hùng Quân

Thứ Sáu, 27 tháng 2, 2026

[Bài 2] Công nghệ chiplet: Giao thức die-to-die (D2D)

Ở phần trước, chúng ta đã nắm bắt các nguyên lý cơ bản của công nghệ Chiplet cũng như động lực thúc đẩy sự ra đời của xu hướng này trong ngành bán dẫn. Trong phần tiếp theo, chúng ta sẽ đi sâu phân tích cơ chế giao tiếp giữa các die (Die-to-Die Interconnects), yếu tố then chốt quyết định hiệu năng và sự thống nhất của toàn bộ hệ thống.


1. Giao tiếp giữa hai chip SoC
Trước khi phân tích cơ chế giúp các chiplet phối hợp vận hành như một thực thể đơn khối (Monolithic), chúng ta cần hiểu làm thế nào để hai vi mạch độc lập có thể thiết lập liên kết dữ liệu. Về cơ bản, việc trao đổi dữ liệu giữa các chip dựa trên các giao thức tiêu chuẩn (Standard Protocols) như SPI, I²C, UART, hay PCIe, ... Ngay cả các tín hiệu thông qua chân GPIO cũng phải tuân thủ các nguyên lý đã được quy định chặt chẽ.
Hình 1. Giao tiếp giữa các chip và thành phần ngoại vi

2. Giao tiếp Die-to-Die (D2D)
Nguyên tắc liên kết Die-to-Die (D2D) về bản chất tương đồng với cơ chế giao tiếp giữa SoC và các thành phần ngoại vi rời rạc. Điều này đồng nghĩa với việc thiết lập liên kết dữ liệu bắt buộc phải dựa trên các giao thức tiêu chuẩn (Standardized Protocols). Tuy nhiên, điểm khác biệt cốt lõi nằm ở việc tối ưu hóa lớp vật lý (PHY) để đạt được băng thông cực cao và độ trễ cực thấp, tiệm cận với hiệu suất của các kết nối nội tại bên trong một chip đơn khối.
Giao tiếp Die-to-Die (D2D) giữa các chiplet được chia thành hai phần chính dựa trên yêu cầu về băng thông và chức năng:
  • Giao diện tốc độ thấp (Low-speed Interface): Đóng vai trò là kênh điều khiển và quản lý hệ thống. Nhiệm vụ cốt lõi bao gồm truyền tải thông số cấu hình, thực thi quy trình bắt tay (handshaking), đồng bộ hóa trạng thái vận hành, và nhận diện cấu trúc chiplet (Discovery). Các giao diện này thường triển khai dựa trên các tiêu chuẩn như I3C, SPI, QSPI hoặc các tín hiệu GPIO tùy biến.
  • Giao diện tốc độ cao (High-speed Interface): Được thiết kế để đáp ứng các kịch bản đòi hỏi băng thông cực lớn (High bandwidth) và độ trễ cực thấp (Ultra-low latency). Đây là luồng dữ liệu chủ đạo (Data Path) phục vụ cho việc truyền tải dữ liệu lớn như đồ họa, xử lý video thời gian thực, và các thao tác truy xuất bộ nhớ tốc độ cao (như DRAM/HBM). Các chuẩn giao tiếp chuyên dụng cho sẽ được trình bày ở phần kế tiếp.
Hình 2. Kiến trúc giao tiếp Die-to-Die (D2D) cơ bản
Trong hình minh họa trên, giao tiếp D2D tốc độ cao gồm các phần cơ bản sau đây:
  • Bộ điều khiển Link (Link controller) là RTL code.
    • Giao tiếp BUS: Hỗ trợ các chuẩn kết nối nội bộ như CHI, AXI, CXS, Wishbone, Avalon ...
    • Mô hình giao dịch (Transaction Model): Quản lý các luồng trao đổi dữ liệu.
    • Đóng gói dữ liệu (Packetization): Chuyển đổi dữ liệu thành các gói tin (packets) tiêu chuẩn.
    • Kiểm soát luồng (Flow Control): Điều phối tốc độ truyền dẫn và ngăn ngừa tràn bộ đệm.
    • Quản lý trạng thái liên kết (Link State Management): Giám sát các chế độ vận hành (Active, Sleep, Power-down) của đường truyền.
  • PHY
    • PHY controller (RTL code)
      • Bắt tay giữa Link và PHY (Link-PHY Handshake): Giao thức phối hợp tín hiệu giữa tầng liên kết và tầng vật lý (ví dụ: chuẩn RDI hoặc CPI).
      • Quản lý trạng thái PHY (PHY State Management): Điều khiển trình tự khởi tạo và duy trì ổn định cho lớp vật lý.
    • Analog (hard macro) PHY: hoạt động như bộ chuyển đổi Số - Tương tự (Digital-Analog Converter) để chuyển đổi dữ liệu logic thành các tín hiệu điện vật lý để truyền dẫn trên kết nối D2D.
Hình 3. Cấu trúc cơ bản của thiết kế D2D

Hình 4. Các chuẩn giao tiếp D2D

Hình 4. Bảng thống kê các chuẩn giao tiếp D2D
3. Mô tả ngắn về các chuẩn
3.1. UCIe - Universal Chiplet Interconnect Express 
  • Website: https://www.uciexpress.org
  • Loại hình: Tiêu chuẩn mở (Open Standard).
  • Phạm vi đặc tả: Định nghĩa toàn diện cả bộ điế khiển Link, bao gồm lớp giao thức (protocol), lớp điều phối (adapter), và lớp vật lý (PHY).
  • Giao diện chuẩn hóa: Xác định các giao thức kết nối tiêu chuẩn giữa lớp giao thức và lớp điều phối (FDI - Flit-aware D2D Interface), cũng như giữa lớp điều phối và lớp vật lý (RDI - Raw D2D Interface).
  • Điểm loại trừ: Không định nghĩa giao diện BUS nội bộ. Giao tiếp BUS này tùy thuộc vào thiết kế riêng của từng nhà phát triển IP.
Hình 5. Giao thức UCIe

3.2 BoW - Bunch of Wires
  • Website: https://www.opencompute.org/
  • Loại hình: Tiêu chuẩn mở
  • Phạm vi đặc tả: Định nghĩa cả phần link controller, bao gồm lớp giao dịch (transaction) và lớp liên kết (link) – theo đặc tả Open Domain Specific Architecture (ODSA), và lớp vật lý (PHY).
  • Giao diện chuẩn hóa: Xác định các giao thức tiêu chuẩn giữa tầng giao dịch và tầng liên kết (TLI - Transaction Link Interface), cũng như giữa tầng liên kết và lớp vật lý (LPI _ Link Physical Interface).
  • Điểm loại trừ: Không định nghĩa giao diện BUS nội bộ kết nối với BUS hệ thống.
Hình 6. Giao thức BoW
3.3 AIB - Advanced Interface Bus
  • Website: Trang chủ Intel (Hiện được duy trì bởi liên minh CHIPS Alliance).
  • Loại hình: Tiêu chuẩn mở.
  • Phạm vi đặc tả: Chỉ định nghĩa lớp vật lý (PHY), trong đó bao gồm AIB Adapter như một cấu phần tích hợp của bộ điều khiển PHY (PHY Controller).
  • Điểm loại trừ: Không định nghĩa lớp liên kết (Link Layer) hay giao diện BUS.
Hình 7. Giao thức AIB
3.4 Chuẩn CEI-112G-MCM, XSR
  • Website: https://www.oiforum.com
  • Loại hình: Tiêu chuẩn mở.
  • Phạm vi đặc tả: Chỉ định nghĩa lớp vật lý (PHY), tập trung vào các đặc tính giao diện và truyền dẫn tín hiệu điện. Chủ yếu giải quyết các yêu cầu về SerDes (Bộ tuần tự hóa/Giải tuần tự hóa) cho các khoảng cách truyền dẫn khác nhau, chẳng hạn như XSR (Khoảng cách cực ngắn) và MCM (Mô-đun đa chip).
Hình 8. Chuẩn CEI-112G
Việc lựa chọn tiêu chuẩn liên kết D2D: Việc xác định các chuẩn và giao thức giao tiếp Die-to-Die (cả Low-speed và High-speed) linh hoạt tùy theo mục tiêu sản phẩm, bao gồm cả các giải pháp tùy chỉnh nội bộ (In-house/Proprietary IP). Tuy nhiên, tính tương thích vật lý, khả năng mở rộng hệ sinh thái và lộ trình công nghệ (Roadmap) phải được xem xét ngay từ giai đoạn định nghĩa kiến trúc (Architectural Definition) trước khi lựa chọn chuẩn để sử dụng.
  • Quy mô và mật độ giao tiếp D2D: Số lượng các kênh giao tiếp D2D không bị giới hạn bởi các quy tắc cố định. Cấu hình cụ thể về số lượng lane (Kênh truyền dữ liệu trên giao tiếp D2D), băng thông tổng thể và loại giao diện được tính toán dựa trên yêu cầu thông lượng dữ liệu (Throughput), kiến trúc phân tầng hệ thống và chiến lược phân vùng chức năng (Functional Partitioning) giữa các die.
  • Xem xét giữa chuẩn nội bộ và chuẩn mở: Việc triển khai các giao thức nội bộ cho phép tối ưu hóa chuyên sâu về băng thông, hiệu năngvà độ trễ. Tuy nhiên, cách tiếp cận này tạo ra rào cản lớn về tính tích hợp giữa các nhà cung cấp IP và hệ thống.
Ngược lại, việc áp dụng các tiêu chuẩn mở (như UCIe, BoW) đảm bảo khả năng tương tác liên thông (Interoperability), giảm thiểu rủi ro thiết kế và thúc đẩy sự phát triển của hệ sinh thái Chiplet mở giữa các nhà sản xuất khác nhau.

Lịch sử cập nhật:
1) 2026.02.27 - Tạo lần đầu - Quan Nguyen

Thứ Ba, 24 tháng 2, 2026

[Bài 1] Công nghệ chiplet: Kiến trúc đơn khối và kiến trúc chiplet

Trong bối cảnh kiến trúc đơn khối (Monolithic) truyền thống gặp hạn chế về tỷ lệ sản phẩm sản xuất đạt yêu cầu (Yield) khi diện tích die tăng, chi phí sản xuất cao ở các tiến trình tiên tiến, và chi phí R&D không tối ưu, công nghệ Chiplet nổi lên như một giải pháp thay thế hiệu quả trong nhiều năm gần đây. Bằng cách phân chia chức năng SoC thành nhiều die mô-đun (chiplet) riêng biệt và kết nối qua các giao tiếp die-to-die, kiến trúc này cho phép tối ưu hóa chi phí trong nhiều trường hợp, đặc biệt là cho các SoC phức tạp cao. Chuổi bài này cung cấp kiến thức nền tảng về cấu trúc Chiplet, các giao thức kết nối phổ biến và chi tiết quy trình khởi động hệ thống (booting flow) trong thiết kế VLSI hiện đại.

1. Kiến trúc đơn khối và kiến trúc chiplet

Kiến trúc đơn khối (Monolithic) đề cập đến một đế bán dẫn tích hợp, trong đó tất cả các khối chức năng của một hệ thống trên chip (SoC) đều được chế tạo trên một nền silicon liên tục duy nhất. Silicon đơn khối đại diện cho cấu trúc truyền thống đang được áp dụng cho đại đa số các thiết kế chip nhỏ và vừa hiện nay.

Hình 1. Chip SoC đơn khối (monolithic SoC) với duy nhất 1 die trong SoC package

Kiến trúc Chiplet là một phương pháp thiết kế hệ thống, trong đó các chức năng của SoC được phân chia thành nhiều đế (die) mô-đun riêng biệt (gọi là các chiplet). Các chiplet này được tích hợp bên trong một gói duy nhất và kết nối với nhau thông qua các liên kết die-to-die (D2D) để vận hành như một hệ thống thống nhất.
Hình 2. Chiplet Soc với 2 chiplet (2 die) trong SoC package

2. Giới hạn của kiến trúc đơn khối

2.1. Tại sao cần tiếp cận kiến trúc chiplet trong các thiết kế SoC lớn và phức tạp?
Khi thiết kế SoC ngày càng lớn, chi phí và rủi ro củng tăng theo. Thiết kế đơn khối bộc lộ các nhược điểm sau đây:
  1. Yield suy giảm theo sự tăng của diện tích die: xác suất lỗi sản xuất tăng phi tuyến theo diện tích die; chỉ một lỗi sản xuất cũng có thể làm hỏng toàn bộ die.
  2. Chi phí cao vì thiếu sự linh hoạt về côn nghệ sản xuất và khả năng tái sử dụng kém: Toàn bộ digital logic, analog IP, và IO PAD buộc dùng cùng một công nghệ sản xuất, dẫn đến chi phí wafer, mask, nghiên cứu, và phát triển rất cao và không tối ưu công nghệ cho từng phần thiết kế. Tất cả IP bị ràng buộc chặt vào một die đơn khối cụ thể, gây khó khăn cho việc tái sử dụng linh hoạt giữa các sản phẩm hoặc cấu hình SoC khác nhau.
  3. Sự phức tạp của thiết kế vật lý (physical design) tăng đột biến: Giải quyết các vấn đề về định thời (timing), tổng hợp cây clock (CTS), mạng lưới cấp nguồn (PDN) và và đảm bảo tính toàn vẹn tín hiệu và nguồn (SI/PI) trở nên khó khăn khi die lớn và mật độ logic cao.
2.2. Yield suy giảm theo sự tăng của diện tích die

Yield (Tỷ lệ sản phẩm đạt) là tỷ lệ thống kê của các đế bán dẫn (dies) sau khi chế tạo đáp ứng đầy đủ tất cả các yêu cầu về chức năng, thông số kỹ thuật và khả năng sản xuất sau quá trình gia công và kiểm thử; tỉ lệ này được quyết định cơ bản bởi mật độ lỗi (defect density), diện tích đế (die area) và sự biến đổi của quy trình (process variability).

Yield thể hiện sự sụt giảm phi tuyến tính khi diện tích die tăng lên. Ví dụ minh họa dưới đây cho thấy sự sụt giảm Yield trên cùng một diện tích wafer khi kích thước die tăng lên gấp bốn lần:

(a) Yield = 'Số die tốt / Tổng số die' = 2/4 = 50%

(b) Yield = 28/32 = 87,5%"

Hình 3. Yield giảm khi kích thước die tăng. (a) yield là 50% (b) Yield là 87.5% khi kích thước wafer không đổi
2.3. Sự linh hoạt về công nghệ sản xuất (process - tiến trình) và tái sử dụng mức silicon
Kiến trúc Monolithic: Toàn bộ đế (die) phải được chế tạo lại từ đầu khi chuyển sang một tiến trình công nghệ khác.
Kiến trúc Chiplet: Chỉ những đế (chiplet) nào yêu cầu chuyển đổi tiến trình mới cần phải chế tạo lại; các đế còn lại có thể được tái sử dụng mà không cần phải thực hiện lại quy trình chế tạo.
Hình 4. Toàn bộ die phải được thiết kế vật lý và sản xuất lại khi chuyển đổi công nghệ từ 7nm lên 5nm

Hình 5. Chỉ die cần phải nâng cấp (die 0) phải thiết kế vật lý và sản xuất lại với công nghệ mới 5nm, còn die 1 sẽ tái sử dụng (tái sản xuất trên công nghệ cũ 7nm) mà không cần thiết kế vật lý lại.

Trong ví dụ trên đây, chúng ta xem xét kịch bản yêu cầu nâng cấp một thiết kế SoC từ tiến trình 7nm lên 5nm cho các khối CPU, NPU, BUS và DSP.
  • Đối với kiến trúc đơn khối: Ngay cả khi các thành phần như MEM (Memory) hay PCIE không có sự thay đổi về mặt thiết kế (RTL), chúng vẫn buộc phải "cuốn chiếu" nâng cấp theo tiến trình mới. Điều này đồng nghĩa với việc toàn bộ các khối Analog Hard Macro (DRAM PHY, PCIE PHY, IO PAD) và thiết kế vật lý (Physical Design) của Logic Digital phải triển khai lại từ đầu. Hệ quả là chi phí R&D tăng vọt và kéo dài đáng kể thời gian đưa sản phẩm ra thị trường (Time-to-Market).
  • Đối với kiến trúc Chiplet: Nếu các khối chức năng đã được phân tách ngay từ đầu dựa trên lộ trình sản phẩm và phân tích chi phí đóng gói, chúng ta sẽ có lợi thế vượt trội về giảm chi phí R&D và thời gian đưa sản phảm ra thị trường. Cụ thể, chỉ có Die 0 (chứa CPU/NPU/BUS/DSP) cần tái đầu tư R&D cho tiến trình 5nm. Toàn bộ Die 1 được bảo lưu hoàn toàn, giúp cắt giảm tối đa chi phí thiết kế và rủi ro kỹ thuật trong quá trình chuyển đổi công nghệ.
2.4. Độ phức tạp của thiết kế vật lý tăng khi sự phức tạp của SoC đơn khối tăng

Bảng 1. So sánh sự phức tạp giữa chip SoC đơn giản (nhỏ và vừa) và chíp SoC phức tạp

Khía cạnh

SoC đơn giản (ít component)

SoC phức tạp (nhiều component)

Floorplanning (bố trí)

Bố trí tương đối trực quan, ít macro, ít ràng buộc chéo.

Floorplan đa khối, nhiều macro lớn (CPU, GPU, NPU, SRAM), ràng buộc vị trí chặt chẽ.

Routing Congestion (nghẽn định tuyến)

Routing (đi dây) tương đối đều, dễ tránh tắc nghẽn.

Congestion cục bộ nghiêm trọng do bus tín hiệu nhiều bit, mang lưới kết nối trong chip và lưu lượng kết nối các IP cao.

Timing Closure

Ít path dài, dễ đóng timing ở số ít corner.

Path dài xuyên nhiều IP, nhiều clock domain, timing closure phi tuyến.

Clock Tree Synthesis (CTS)

Một hoặc ít clock domain, skew dễ kiểm soát.

Nhiều clock domain (hàng trăm, hàng nghìn), clock gating phức tạp, khó kiểm soát skew.

Power Delivery & Integrity (PDN/PI)

Dòng tiêu thụ thấp, rơi áp và nhiễu nhỏ, mạng lưới cấp nguồn đơn giản.

Dòng lớn, hotspot cục bộ, rơi áp, và nhiễu dễ xảy ra.

Signal Integrity (SI)

Ít dây dẫn tốc độ cao, coupling thấp.

Nhiều dây dẫn tốc độ cao song song, nhiễu xuyên kênh (crosstalk) và suy giảm tín hiệu dễ xuất hiện.


Tại sao foorplanning của SoC lớn lại khó hơn? Floorplanning là giai đoạn xác định vị trí tối ưu và phân bổ không gian cho các khối chức năng chính (như CPU, SRAM, NPU,...) trên đế silicon (die). Mục tiêu cốt lõi của bước này là thiết lập một khung sườn vật lý vững chắc, đảm bảo khả năng định tuyến (routability), tối ưu hóa diện tích và kiểm soát các yếu tố về định thời (timing) cũng như phân phối điện năng (power distribution).
Khi SoC ngày càng lớn, số lượng các khối chức năng vật lý tăng lên việc bố trí để thỏa nhiều điều kiện khác nhau như đã nói sẽ trờ nên khó khăn hơn.
Tại sao việc đóng/hội tụ timing (timing closure) của SoC lớn lại khó hơn? Timing Closure (Hội tụ định thời) là trạng thái mà toàn bộ các đường dẫn tín hiệu trong thiết kế đều thỏa mãn các ràng buộc về thời gian (timing constraints). Điều này bao gồm việc đáp ứng các điều kiện về Setup time và Hold time đối với các đường dẫn dữ liệu (Data Path), cũng như Recovery time và Removal time đối với các đường dẫn reset (Reset Path). Trạng thái này phải được đảm bảo duy trì ổn định trên tất cả các kịch bản hoạt động (scenarios) và mọi điều kiện góc kỹ thuật (PVT corners - Process, Voltage, Temperature).
SoC phức tạp sẽ có số lượng miền clock lớn; tần số clock yêu cầu cao; số lượng data path, reset path nhiều; ... sẽ làm cho timing closure khó hơn.
Hình 6. (Hình bên trái) Minh họa floorplanning; (Hình bên phải) Minh họa routing trong đó có thể xuất hiện đường timing path dài (long timing path) gây vi phạm định thời (timing)
Tại sao tắc nghẽn định tuyến lại dễ xuất hiện trong chip SoC lớn? Hiện tượng tắc nghẽn định tuyến (Routing congestion) phát sinh khi nhu cầu về mật độ dây dẫn vượt quá tài nguyên không gian vật lý hiện có trên die.
Khi độ phức tạp của thiết kế tăng lên, số lượng các đường liên kết giữa các thành phần trên chip (on-chip components) phát triển một cách đáng kể, dẫn đến tình trạng tắc nghẽn định tuyến (routing congestion). Sự tắc nghẽn này cần được phân tích và xử lý triệt để ngay từ giai đoạn RTL cho đến suốt quá trình triển khai vật lý (physical implementation).
Hình 7. Minh họa việc thiết kế có số lượng dây kết nối lớn gây hiện tượng routing congestion (tham khảo: https://www.arteris.com/learn/wire-routing-congestion) 

Tại sao tổng hợp cây clock (CTS) khó khăn hơn? CTS (Clock Tree Synthesis - Tổng hợp cây xung nhịp) là quy trình xây dựng mạng lưới phân phối xung nhịp từ nguồn (Clock Source/Root) đến tất cả các điểm cuối (Sinks) như các Flip-flops hoặc các chân xung nhịp của các khối Macros bên trong chip. Mục tiêu cốt lõi của CTS là tối thiểu hóa độ lệch xung nhịp (Clock Skew) và độ trễ chèn (Insertion Delay). Trước khi thực hiện bước CTS, xung nhịp trong thiết kế chỉ được coi là xung nhịp lý tưởng (Ideal Clock) và chưa được lan truyền (Propagated) qua mạng lưới dây dẫn vật lý.
Một thiết kế SoC lớn với số lượng Flip-flop lớn và nhiều miền clock, việc CTS tốt sẽ mất thời gian hơn.
Hình 8. Minh họa tổng hợp cây clock (Clock Tree Synthesis - CTS)

Tại sao thiết lập mạng lưới phân phối nguồn lại khó hơn trong các chip SoC lớn? Mạng lưới phân phối nguồn (Power Delivery Network - PDN) là hệ thống các đường dẫn vật lý (metal grids) và các thành phần liên kết bên trong chip, có nhiệm vụ đảm bảo cung cấp điện áp ổn định và đồng nhất đến mọi khối chức năng. Một PDN tối ưu phải kiểm soát được hiện tượng sụt áp (IR Drop), nhiễu nguồn (Power Noise) trong giới hạn cho phép, và đảm bảo tính toàn vẹn điện năng (Power Integrity - PI) cho toàn bộ hệ thống.
Một thiết kế SoC với nhiều IP analog (hard macro) khác nhau thường yêu cầu nhiều power domain và nhiều vị trí cấp nguồn khác nhau (nhiều chân cấp nguồn hơn).
Hình 9. Các SoC lớn thường yều cầu nhiều power domain

Tại sao việc đảm bảo PI lại khó hơn? Trong ví dụ này, việc bố trí CPU và DSP — hai khối chức năng hoạt động với tần suất cao — nằm sát nhau tại cạnh trên của die đã gây ra sự tập trung công suất và nhiệt năng cục bộ, hình thành các điểm nóng vượt ngưỡng (Thermal Hotspots). Hotspot trong SoC là những vùng có mật độ công suất (Power Density) và nhiệt độ cao bất thường so với khu vực lân cận, phát sinh do hoạt động chuyển mạch với cường độ lớn. Hiện tượng này không chỉ gây ra ứng suất nhiệt mà còn trực tiếp làm suy giảm tính toàn vẹn điện năng (Power Integrity) do sự biến đổi đặc tính dẫn điện theo nhiệt độ.
Để tối ưu hóa, cấu trúc Floorplan cần được điều chỉnh bằng cách giãn cách vật lý giữa CPU và DSP, giúp dàn trải dòng nhiệt và tối ưu hóa khả năng tản nhiệt tự nhiên của die. Bên cạnh đó, các cảm biến nhiệt độ (Thermal Sensors) và cảm biến điện áp (Voltage Monitors) được tích hợp tại các vị trí chiến lược để giám sát trạng thái thời gian thực. Dữ liệu từ hệ thống giám sát này đóng vai trò là thông số đầu vào cho các thuật toán DVFS (Dynamic Voltage and Frequency Scaling), cho phép hệ thống tự động điều chỉnh tần số xung nhịp hoặc mức điện áp nguồn, từ đó ngăn chặn tình trạng quá nhiệt và kiểm soát hiện tượng sụt áp (IR Drop) hiệu quả."
Hình 10. Bên trái: hotspot xảy ra khi hai thành phần hoạt động và tiêu thụ năng lượng chính, CPU và DSP, đặt gần nhau; Bên phải: Hai thành phần hoạt động chính được bố trí cách xa nhau để tránh việc cộng hưởng nhiệt gây hotspot. 

Khi độ phức tạp của SoC tăng cao, việc phân tích tính toàn vẹn tín hiệu (Signal Integrity - SI) trở thành yêu cầu bắt buộc trong quy trình sign-off. Chẳng hạn, nếu không tối ưu hóa vị trí đặt (Placement) của các khối giao tiếp ngoại vi tốc độ cao (như PCIe Gen5/6, DDR5), các đường truyền tín hiệu sẽ bị kéo dài hoặc đi quá gần nhau, làm gia tăng hiện tượng nhiễu xuyên âm (Crosstalk). Điều này không chỉ gây biến dạng dạng sóng mà còn dẫn đến các lỗi về định thời và suy giảm tỷ số tín hiệu trên nhiễu (SNR), gây khó khăn cho việc kiểm soát nhiễu ở giai đoạn định tuyến.
Hình 11. Bên trái: 2 ngoại vi tốc độ cao PCIe bố trí gần nhau dễ gây tình trạng nhiễu (ảnh hưởng) tín hiệu khi cả hai cùng hoạt động truyền tốc độ cao. Bên phải: 2 ngoại vi được bố trí lại khi thiết kế vật lý để đảm bảo SI.

Những phân tích trên đây giúp làm rõ sự gia tăng mức độ khó khăn trong thiết kế vật lý của kiến trúc chip đơn khối khi độ phức tạp của thiết kế tăng lên.
Việc chuyển đổi từ kiến trúc đơn khối (Monolithic) sang phương thức tiếp cận dựa trên Chiplet có thể giúp cắt giảm một số thành phần chi phí nhất định. Tuy nhiên, mô hình này lại làm gia tăng độ phức tạp của hệ thống và các chi phí liên quan đến đóng gói chip (packaging).
Do đó, hiệu quả giảm tổng chi phí thực tế cần phải được đánh giá thông qua một bản phân tích định lượng toàn diện trên toàn bộ chuỗi giá trị, bao gồm các giai đoạn: thiết kế, chế tạo wafer, đóng gói tiên tiến (Advanced Packaging), kiểm thử, tích hợp hệ thống.

Lịch sử cập nhật:
1) 2026.02.22 - Tạo lần đầu - Quan Nguyen

Chủ Nhật, 1 tháng 3, 2020

[Low Power] Các kỹ thuật thiết kế giúp giảm công suất tiêu thụ

Bài viết này trình bày khái niệm cơ bản về công suất thấp và các kỹ thuật giúp giảm công suất tiêu thụ trong thiết kế số. Trong đó, nội dung tập trung vào các kỹ thuật ở mức front-end, thiết kế kiến trúc và thiết kế RTL, có thể áp dụng được. Các kỹ thuật được ở mức back-end chỉ được mô tả cơ bản.

1) Tổng quan về khái niệm công suất thấp (low power)
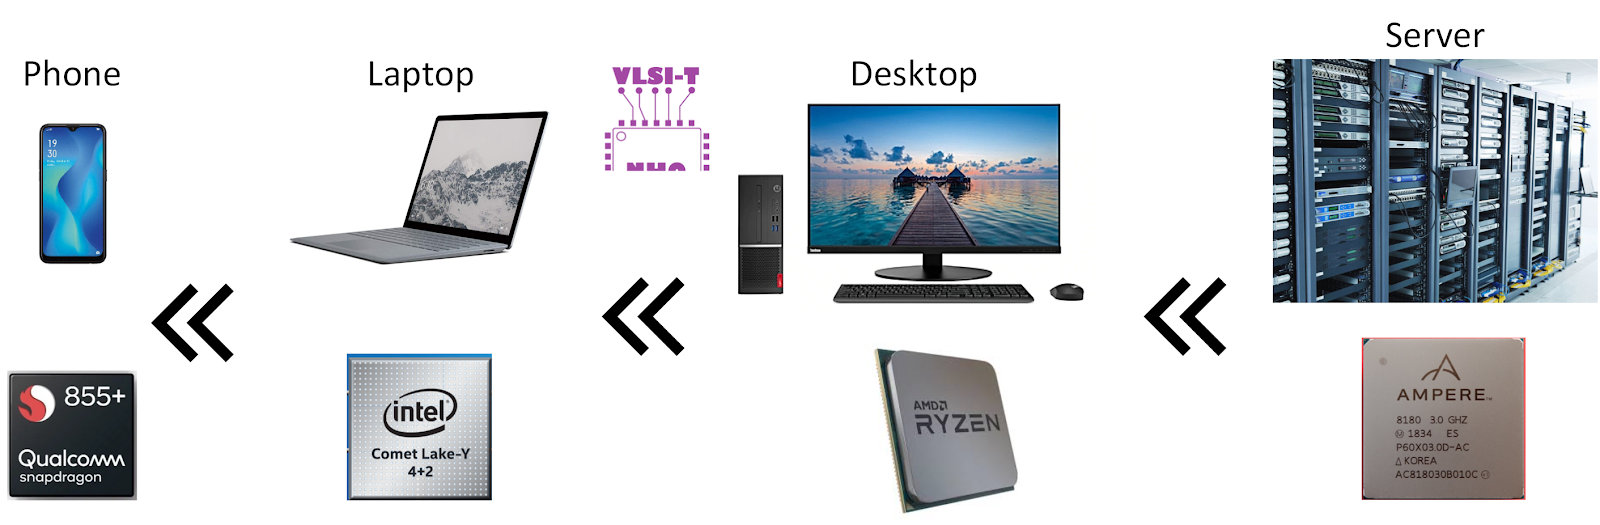
Trên thị trường hiện nay, hiệu suất cao (high performance) và công suất thấp (low power) là hai yếu tố góp phần lớn vào khả năng thương mại của một vi mạch. Tùy ứng dụng cụ thể, việc tối ưu công suất tiêu thụ được hỗ trợ ở các mức độ khác nhau. Ví dụ:
  • Vi mạch dùng trong điện thoại yêu cầu mức tiêu thụ công suất ít hơn vi mạch dùng trong laptop. Bạn chắc chắn không muốn dùng một chiếc điện thoại mà phải đeo thêm một bình ắc quy để cấp nguồn cho nó.
  • Vi mạch dùng trong laptop yêu cầu mức tiêu thụ công suất ít hơn vi mạch dùng trong máy tính để bàn (desktop).
  • Vi mạch dùng trong máy tính để bàn yêu cầu mức tiêu thụ công suất ít hơn vi mạch dùng trong máy chủ (server).

Hình 1: Minh họa công suất tiêu thụ tăng dần từ trái qua phải tùy vào ứng dụng
Tiêu chí công suất thấp đã trở thành yếu tố ngày càng quan trọng và được dùng để so sánh giữa các chip cùng phân khúc thị trường. Đặc biệt, đối với các ứng dụng dùng Pin, thiết bị di động (smart watch, smart phone, laptop, …), thiết bị dùng nguồn năng lượng từ tín hiệu không dây (contactless card, RFID card,…), … thì việc tiêu thụ công suất thấp đến cực thấp (ultra-low power) hay siêu thấp (extreme-low power) là trở thành yêu cầu tối quan trọng.
Nếu hai dòng chip tương đương nhau về chức năng và hiệu suất thì chip nào tiêu thụ công suất ít hơn thì chip đó có hiệu quả sử dụng năng lượng (power efficient) tốt hơn.
Chú ý rằng, đối với một chip, “công suất thấp” phải đi đôi với “hiệu quả sử dụng năng lượng”. Một chip rơi vào một trong hai trường hợp sau đây đều bị đánh giá là có hiệu quả sử dụng năng lượng thấp :
  • Một chip tiêu thụ công suất rất thấp nhưng xử lý chậm chạp, hiệu năng kém hoặc không đủ đáp ứng nhu cầu ứng dụng.
  • Một chip xử lý cực nhanh, thời gian xử lý trung bình đáp ứng gần như 100% các yêu cầu của ứng dụng nhưng tiêu thụ công suất gấp nhiều lần các chip khác cùng loại.
Như vậy, việc thiết kế công suất thấp cần được cân bằng với hiệu quả xử lý. Điều này dẫn đến phạm vi ứng dụng các kỹ thuật công suất thấp trong chip sẽ khác nhau.
2) Công suất tiêu thụ của logic bên trong chip
Trước khi tìm hiểu các kỹ thuật tối ưu công suất, chúng ta cần biết mạch logic bên trong chip (cổng logic, Flip-Flop, Latch, …) sẽ tiêu thụ công suất như thế nào? và điều gì ảnh hưởng đến công suất tiêu thụ của các logic này? Hiểu được nguồn gốc của việc tiêu thụ công suất trong mạch logic giúp chúng ta giải thích được nguyên lý và ảnh hưởng của các kỹ thuật thiết kế công suất thấp.
Hình 2: Cấu tạo bên trong một chip (IC)
Chúng ta nhìn sâu vào bên trong một chip. Công suất tiêu thụ của một chip chủ yếu liên quan đến hoạt động của các CMOS. Về cơ bản, tổng công suất tiêu thụ (Ptotal) gồm:
Ptotal = Pactive + Pleakege = Pdynamic + Psc + Pleakage
Công suất tiêu thụ trong mạch logic chia làm hai loại:
  • Công suất tích cực (active power, Pactive) là năng lượng tiêu tiêu thụ khi mạch logic (cổng logic) chuyển mạch (switching).
    • Công suất động (dynamic power, Pdynamic), còn gọi là công suất chuyển mạch (switching power), là năng lượng cần có cho việc nạp hoặc xả trên tụ điện ở tải ngõ ra (load capacitance)
    • Công suất ngắn mạch (short circuit power, Psc) là năng lượng tiêu hao do dòng ngắn mạch từ nguồn (source) đến đất (ground) xuất hiện trong khi các CMOS chuyển trạng thái.
Hình 3: Cấu trúc CMOS của cổng đảo (inverter, NOT)
Hình 4: Minh họa các dòng sinh ra công suất tích cực khi xảy ra chuyển mạch trên một cổng đảo (a) Dòng nạp khi ngõ vào In chuyển mức logic từ 1 sang 0 (b) Dòng xả khi ngõ vào In chuyển mức logic từ 0 sang 1 (c) Dòng ngắn mạch trong khi chuyển mạch
  • Công suất tĩnh (static power), còn gọi là công suất rò (leakage power, Pleakage) là năng lượng hao tổn do dòng rò, sinh ra khi logic trong trạng thái ổn định (steady-state), không có sự chuyển mạch. Các nguồn dòng rò gồm:
    • I1: Dòng rõ dưới ngưỡng (Subthreshold leakage, ISUB), ký hiệu là Isub, là dòng từ cực D đến cực S. Dòng rò này sinh ra do phân cực yếu, dưới mức ngưỡng.
    • I2: (Drain-Induced Barrier Lowering – DIBL)
    • I2’: Dòng puchthrough (Channel punchthrough current)
    • I3: Dòng rò đường ống trực tiếp từ cực G (Gate direct-tunneling leakage current) sinh ra do độ dày lớp “gate oxide” mỏng nên có các điện tử di chuyển qua lại giữa cực G và chất nền.
    • I4: Dòng rò cực D do cảm ứng cực G (Gate-induced drain leakage current, GIDL).
    • I5: Dòng rò ngược trên lớp tiếp giáp p-n (reverse-biased junction leakage current), còn gọi là dòng rò diode. Dòng này chảy từ cực S hoặc D đến chất nền (substrate).
    • I6: Dòng cực cổng G do tiêm chất mang nóng (Gate current due to hot-carrier injection)
Hình 5: Các loại dòng rò trên CMOS
Các kỹ thuật giúp giảm công suất tiêu thụ của một vi mạch được gọi chung là “kỹ thuật thiết kế công suất thấp” (low power design technique hoặc low power technique). 
Mỗi kỹ thuật thiết kế công suất thấp có mức ảnh hưởng khác nhau, có kỹ thuật giúp giảm công suất tiêu thụ đáng kể, có kỹ thuật chỉ giúp giảm ít. Mỗi kỹ thuật cũng có mục tiêu giảm công suất khác nhau, có kỹ thuật giúp giảm công suất tích cực, có kỹ thuật giúp giảm công suất sinh ra do dòng rò. 
3) Khả năng giảm công suất tiêu thụ 
3.1) Tổng quan 
Căn cứ trên các loại công suất tiêu thụ đã trình bày, việc giảm công suất tiêu thụ dựa trên: 
  • Giảm công suất tích cực (Pactive) 
  • Giảm công suất dò dòng rò (Pleakage) Công nghệ có kích thước lớn, công suất dòng rò chỉ chiếm một tỷ lệ rất nhỏ so với công suất tích cực. Công nghệ có kích thước càng thấp công suất dòng rò chiếm tỷ lệ đáng kể.
Hình 6: Tỷ lệ tiêu thụ năng lượng giữa công suất động và công suất dòng rò theo công nghệ
3.2) Khả năng giảm công suất tích cực 
3.2.1) Giảm công suất động (Pdynamic)
Việc tiêu thụ công suất động trên một mạch logic (một cổng, một nhóm mạch logic hoặc một chip) là tổng của công suất tiêu thụ nhất thời (Transient Power Consumtion, PT) và công suất tiêu thụ trên tải điện dung (Capacitive-Load Power Consumption, PL).
Công suất tiêu thụ nhất thời được tính theo công thức sau:
Trong đó: 
  • Nsw là số bit chuyển mạch. Nếu chỉ có một bit chuyển mạch thì Nsw=1. 
  • Cpd là điện dung của việc tiêu tán năng lượng động. Nó là điện dung nội được tính khi không tải và ngõ ra không chuyển mạch. 
  • Vdd là điện áp nguồn 
  • fi là tần số tín hiệu ngõ vào
Công suất tiêu thụ trên tải điện dung được tính theo công thức sau:
Trong đó: 
  • Nsw là số ngõ ra chuyển mạch. Nếu chỉ có một bit chuyển mạch thì Nsw=1. 
  • CL là điện dung tải ở ngõ ra. Đây là điện dung ngoài 
  • Vdd là điện áp nguồn 
  • fo là tần số tín hiệu ngõ ra 
Các công thức trên cho thấy rằng việc tiêu thụ công suất có thể được giảm bằng cách: 
  • Giảm Nsw bằng cách giảm số bit trên các tín hiệu. 
  • Giảm CL bằng cách giảm số lượng fanout, số lượng kết nối từ ngõ ra của một cổng logic đến ngõ vào của các cổng logic khác. 
  • Giảm Cpd là phần điện dung ký sinh trong linh kiện CMOS nên phụ thuộc công nghệ nên không giảm được Cpd trên mỗi linh kiện CMOS mà chỉ có thể giảm được tổng điện dung kí sinh bằng cách tối ưu tài nguyên thiết kế. 
  • Giảm Vdd bằng cách giảm điện áp sử dụng. Giảm fi và fo bằng cách giảm số lượng chuyển đổi mức logic, chuyền từ 0 sang 1 hoặc từ 1 xuống 0, trên các tín hiệu, bao gồm cả tín hiệu clock và các tín hiệu khác.
3.2.2) Giảm công suất ngắn mạch (Psc)
Mạch CMOS bao gồm một phần nối lên nguồn Vdd (pull-up), một phần nối đất (pull-down). Khi chuyển mạch, trong một khoảng thời gian rất ngắn, cả hai phần cùng dẫn làm cho hiện tượng ngắn mạch sẽ xảy ra. Dòng Isc sinh ra chảy từ nguồn xuống đất gọi là dòng ngắn mạch gây tiêu hao năng lượng.
Hình 7: Cấu trúc mạng CMOS của một cổng NAND
Công suất ngắn mạch được tính như sau:
Trong đó: 
  • Nsw là số lượng cổng chuyển mạch. Nếu chỉ có một cổng thì Nsw=1. 
  • β (beta) là độ lợi của CMOS 
  • Vdd là điện áp nguồn 
  • Vt là điện áp ngưỡng 
  • f là tần số chuyển mạch, số lượng chuyển mạch trong 1 giây.
  • τ (tô) là gian chuyển cạnh lên/xuống của ngõ vào.
Hình 8: Thời gian xuất hiện hiện tượng ngắn mạch trên cổng đảo
Việc giảm công suất ngắn mạch dựa trên các thông số sau:
  • Giảm Nsw bằng cách tối ưu tài nguyên giảm số lượng cổng.
  • Giảm f bằng cách giảm số lần chuyển trạng thái ở các ngõ vào.
  • Giảm beta, phụ thuộc vào công nghệ.
  • Giảm Vdd và tăng Vt phụ thuộc vào công nghệ và khâu thiết kế vật lý.
  • Giảm τ (tô), phụ thuộc vào công nghệ.
Trong các yếu tố trên, khâu thiết kế front-end chỉ có thể tác động đáng kể vào 2 yếu tố là Giảm Nsw và giảm f.

3.3) Khả năng giảm công suất dòng rò

Dòng rò luôn tồn tại khi mạch logic được cấp nguồn. Nó là nguyên nhân tiêu tốn năng lượng đáng kể khi mạch logic không tích cực. Hai thông số ảnh hưởng lớn đến dòng rò là:
  • Điện áp nguồn Vdd
  • Điện áp ngưỡng Vt
Ở đây, tác giả không xét đến yếu tố công nghệ hay cấu trúc CMOS mà chỉ xét đến những yếu tố mà người thiết kế có thể tác động được khi sử dụng một thư viện công nghệ cố định.
4) Kỹ thuật thiết kế công suất thấp được áp dụng ở khâu nào?
Để giảm công suất trong một vi mạch, các kỹ thuật tối ưu công xuất cần được áp dụng đồng bộ từ khâu front-end, đến khâu back-end và công nghệ sử dụng. Ở đây, tác giả phân các mức thiết kế như sau:
  • Thiết kế kiến trúc hệ thống: thiết kế cấu trúc tổng quan, phân tích hệ thống, phương pháp và cơ chế giúp giảm công suất toàn chip và từng miền trong chip.
  • Thiết kế RTL: Phân tích các phương pháp giúp giảm công suất trong một thành phần, một khối hoặc một IP cụ thể
  • Thiết kế vật lý: Các kỹ thuật liên quan đến tổng hợp và layout
  • Công nghệ: Các kỹ thuật liên quan đến việc chỉnh sửa và tối ưu cell và CMOS của thư viện công nghệ (thư viện dùng để chế tạo và sản xuất chip)
Hình 9: Các mức thiết kế
Một số kỹ thuật thiết kế công suất thấp cần có sự phối hợp thực hiện ở nhiều mức thiết kế nhưng một số kỹ thuật chỉ áp dụng ở một mức thiết kế nào đó. Bài viết này tập trung vào các kỹ thuật có thể áp dụng trong thiết kế kiến trúc hệ thống và thiết kế RTL thuộc khâu front-end.
Thiết kế kiến trúc hệ thống quyết định đến công suất tiêu thụ toàn chip. Công suất tiêu thụ có thể giảm tối đa bao nhiêu là tùy thuộc vào bước này. Nó sẽ ảnh hưởng đến khả năng áp dụng các kỹ thuật giảm công suất ở các mức thiết kế khác. Ví dụ, ở mức thiết kế kiến trúc, một miền nào đó được quyết định “phải luôn được cấp clock” trong suốt quá trình hoạt động thì kỹ thuật “clock gating” không được dùng để on/off clock cho toàn miền để giảm công suất tích cực.
Thiết kế RTL là thiết kế chi tiết các thành phần logic, lõi IP trong một chip. Dựa trên yêu cầu chung của thiết kế kiến trúc, bước này áp dụng các kỹ thuật phù hợp để giảm công suất ở phạm vi cục bộ ở từng thành phần logic. Ví dụ, lõi IP A thuộc miền luôn được cấp clock tuy nhiên các block trong lõi IP có thể được áp dụng kỹ thuật clock gating để on/off clock cho từng thành phần dựa trên yêu cầu hoạt động cụ thể. Bên cạnh đó, RTL code của các logic bên trong từng block sẽ được mô tả theo hướng cho phép bước “thiết kế vật lý” có thể chèn các cell clock gating để on/off clock.
Thiết kết vật lý được hiểu là các bước từ tổng hợp (synthesis) xuống đến layout. Cũng căn cứ trên yêu cầu chung của thiết kế kiến trúc và chức năng cụ thể của thiết kế RTL, bước này áp dụng các kỹ thuật phù hợp đế tối ưu công suất tiêu thụ. Ví dụ, bước synthesis sẽ quyết định việc chèn hay không chèn các cell clock-gating.
Hình 10: Minh họa sự ảnh hưởng của các mức thiết kế đến kỹ thuật clock gating
Trong hình minh họa trên, kỹ thuật clock gating không được dùng để tắt clock của miền C vì miền này yêu cầu luôn cấp clock trong suốt quá trình hoạt động. Tuy nhiên ở mức thiết kế RTL, các thành phần logic trong miền C có thể được áp dụng kỹ thuật clock gating để tắt clock các FF khi không cần cập nhật giá trị mới.
5) Một số phương pháp giảm công suất tiêu thụ
5.1) Phân chia miền clock (Multi clock domain)
5.1.1) Mô tả kỹ thuật
Phân chia miền clock là kỹ thuật sử dụng nhiều nguồn clock, có thể đồng bộ hoặc bất đồng bộ, có tần số khác nhau trong một vi mạch. Khi áp dụng kỹ thuật này, giao tiếp giữa các miền clock cần có cơ chế bắt tay hoặc đồng bộ. Các kỹ thuật đồng bộ giữa các miền clock bất đồng bộ có thể được tham khảo ở đây.
Hình 11: Kỹ thuật phân chia miền clock (multi clock domain)
Trong một vi mạch, không phải tất cả các thành phần đều cần hoạt động với tần số cao nhất. Mỗi thành phần phải được xem xét trên hoạt động tổng thể và ứng dụng để quyết định tần số hoạt động thực tế. Tần số của clock chỉ cần được cấp đủ để một thành phần chức năng đảm bảo tốc độ xử lý với các ứng dụng yêu cầu.
Bên cạnh đó, trong một thành phần chức năng (một lõi IP, một khối), tất cả các giao tiếp và logic không cần phải hoạt động cùng một tần số. Tùy vào thực tế ứng dụng, mỗi phần logic cũng có thể được cấp một tần số khác nhau.
Ví dụ, một lõi IP truy xuất bộ nhớ SRAM có hai đường giao tiếp, một giao tiếp AXI dùng để truy xuất bộ nhớ và một giao tiếp APB dùng để cấu hình hoạt động, kiểm tra trạng thái. Việc truy xuất bộ nhớ là một hoạt động thường xuyên và cần tốc độ nhanh nên cần tần số cao. Việc cấu hình hoạt động và kiểm tra trạng thái thường chỉ thực hiện vài lần, trước khi hoạt động hoặc trong các trường hợp đặc biệt chứ không thường xuyên nên không cần tần số cao.
Hình 12: Phân chia miền clock trong một lõi IP
5.1.2) Khả năng giảm công suất
Kỹ thuật này giúp giảm số lần chuyển mạch bằng cách sử dụng các clock chậm cho thành phần không yêu cầu tốc độ xử lý cao. Việc sử dụng clock chậm hơn giúp:
  • Giảm chuyển mạch trên các FF/Latch do thay đổi mức logic của xung clock hoặc thay đổi mức logic trên các ngõ vào của FF.
  • Giảm chuyển mạch trên các mạch tổ hợp sử dụng ngõ ra của các FF/Latch.
Khi tín hiệu clock chuyển mức logic, các logic của FF sẽ bị chuyển mạch làm tiêu hao năng lượng. Sử dụng clock có tần số càng cao thì hoạt động chyển mạch càng xảy ra nhiều và FF tiêu thụ năng lượng càng lớn. Vì vậy, việc giảm tần số giảm công suất tiêu thụ trên các FF.
Hình 13: Cấu trúc của một Flip-Flop (FF)
Hình trên là mạch nguyên lý và hoạt động của một FF khi clock CK ở mức logic 0 và mức logic 1. Việc chuyển mức logic của clock CK sẽ gây chuyển mạch liên tục trên các cổng truyền T1, T2, T3 và T4. Hoạt động của FF và Latch được giải thích chi tiết ở bài viết này.
Hình 14: Ảnh hưởng của tần số xung clock đến khả năng giảm công suất
Đối với các mạch tổ hợp sử dụng ngõ ra của các FF/Latch thì tốc độ chuyển mạch tối đa bằng tần số xung clock. Giả sử ngõ ra của các FF luôn thay đổi mức logic theo cạnh lên xung clock thì mạch tổ hợp sử dụng các ngõ ra này cũng thay đổi tối đa theo các cạnh lên xung clock. Như vậy, việc giảm tần số xung clock giúp giảm tốc độ chuyển mạch trên các mạch tổ hợp (ví trí 2 trong hình minh họa 14).
Bên cạnh đó, ngõ ra của các FF (ví trí 3 trong hình minh họa 14) và mạch tổ hợp sẽ tiếp tục được nối đến ngõ vào của các FF khác. Vì vậy, giảm tần số hoạt động sẽ góp phần giảm chuyển mức logic trên các ngõ vào FF (chân D và chân reset), từ đó, giúp giảm chuyển mạch trên FF.
5.1.3) Công việc ở các mức thiết kế
Mức kiến trúc hệ thống:
  • Phân tích và phân chia các miền clock
  • Phân tích cấu trúc cây clock trong hệ thống
Mức thiết kế RTL:
  • Thiết kế các bộ điều khiển clock, bộ chia clock
  • Kết nối đúng nguồn clock đến từng thành phần
  • Áp dụng các kỹ thuật đồng bộ trên các kết nối giữa các miền clock bất đồng bộ
Mức thiết kế vật lý:
  • Thực hiện tổng hợp và layout tối ưu theo từng miền clock
  • Đảm bảo không có vi phạm timing trong từng miền clock
5.2) Hiệu chỉnh tần số clock (clock frequency scaling)
Hiệu chỉnh tần số là kỹ thuật thay đổi tần số clock cấp cho các thành phần logic để phù hợp với chế độ và điều kiện hoạt động của chip. Việc thay đổi tần số có thể thực hiện thông qua các thông số cấu hình cố định (static) hoặc tự động trong quá trình hoạt động (dynamic).
Hiệu chỉnh tần số tĩnh (static frequency scaling): Tần số clock cấp cho một thành phần logic có thể được cấu hình tùy thuộc vào chế độ hoạt động. Một tần số cố định sẽ được cấp cho thành phần logic sau khi việc cấu hình hoàn tất.
Hiệu chỉnh tần số động (dynamic frequency scaling): Tần số clock cấp cho một thành phần logic có thể tự động điều chỉnh dựa trên điều kiện hoạt động thực tế như nhiệt độ, điện áp, … Ví dụ, để tránh quá nhiệt, một chip sẽ được tích hợp cảm biến nhiệt độ bên trong. Khi nhiệt độ quá ngưỡng cho phép, tần số clock của một vài thành phần như CPU sẽ bị giảm. Lúc này, hiệu năng xử lý chung của chip sẽ bị giảm nhưng vẫn đảm hoạt động đúng chức năng.
Tham khảo công nghệ SpeedStep của Intel, đây là công nghệ cho phép quản lý năng lượng CPU hiệu quả thông qua việc hỗ trợ nhiều mức tần số và điện áp hoạt động khác nhau.
Hình 15: Bảng liên hệ giữa tần số hoạt động tối đa và điện áp sử dụng trên CPU Pentium M của Intel

5.3) Tối ưu tài nguyên (resource) 
5.3.1) Mô tả kỹ thuật 

Tối ưu tài nguyên là kỹ thuật cần được xem xét hàng đầu trong tất cả các kỹ thuật giảm công suất tiêu thụ. Tối ưu tài nguyên nghĩa là loại bỏ hoặc giảm bớt các khối chức năng và cổng logic nhưng vẫn đảm bảo yêu cầu kỹ thuật chung của chip. 
Tài nguyên ở đây có thể được quy về đơn vị cổng (gate) để định lượng. Một đơn vị cổng là một cổng NAND 2 ngõ vào, 1 ngõ ra. Ví dụ, một chip có tổng tài nguyên là 1 triệu cổng không có nghĩa là chip được cấu tạo từ 1 triệu cổng NAND mà nó được cấu tạo bằng nhiều loại cổng logic khác nhau nhưng được quy tương đương với 1 triệu cổng NAND. 
Tùy vào tình huống cụ thể, một số phương pháp sau đây có thể được áp dụng: 
  • Tối ưu cấu trúc và thuật toán: Một chức năng có thể được thực hiện bằng nhiều cách khác nhau. Mỗi cách thực hiện sẽ có số lượng tài nguyên sử dụng tối thiểu khác nhau. Việc lựa chọn cấu trúc và thuật toán quyết định lớn đến khả năng tối ưu tài nguyên. 
  • Chia sẻ tài nguyên: nhiều chức năng dùng chung một khối chức năng, mạch tổ hợp hay mạch tuần tự trong một thiết kế. 
  • Loại bỏ logic không sử dụng: xóa bỏ phần logic không sử dụng trong các thiết kế ở mức RTL code hoặc gate netlist. 
Về việc tối ưu cấu trúc, các bạn có thể tham khảo bài viết về lõi IP mã hóa AES-128 để thấy được sự ảnh hưởng trong việc lựa chọn cấu trúc và thuật toán. Trong bài viết này, tài nguyên mạch tổ hợp có thể giám đến 50% khi thuật toán tính S-BOX được thực hiện theo phương pháp biến đổi toán học thay vì dùng MUX. 
Một số trường hợp phổ biến khác được sử dụng thường xuyên đó là: 
  • Sử dụng số bit mã hóa tối thiểu. Ví dụ, một máy trạng thái (FSM) có 6 trạng thái thì dùng 3 bit để mã hóa.
  • Dùng phương pháp dịch để thực hiện các phép nhân với 2^n. Ví dụ, việc nhân một số được biểu diễn bằng 4 bit với 4 tương đương với việc dịch trái 2 bit.
Hình 16: Dùng dịch trái thay cho bộ nhân trong các phép nhân với 2^n
Hình trên cho thấy việc thực hiện phép nhân một số 4 bit với giá trị 4 (2^2) bằng phương pháp dịch trái sẽ không cần dùng bất cứ logic nào. 
Một ví dụ khác, một khối chức năng nhận nối tiếp từng gói 8 bit nhị phân rồi chuyển đổi từng gói 8 bit thành mã Gray trước khi ghép lại thành một gói 512 bit gửi đến khối khác. Khối này có thể được thiết kế như sau: 
  • Sử dụng 64 bộ chuyển đổi mã Gray để biến đổi cùng lúc 512 bit.
  • Sử dụng 1 bộ chuyển đổi mã Gray để biến đối nối tiếp từng nhóm 8 bit. Cách này tiết kiệm tài nguyên và nhiều ưu điểm hơn cách đầu.
Hình 17: Một ví dụ về việc thay đổi cấu trúc để tối ưu tài nguyên
Về kỹ thuật chia sẻ tài nguyên, kỹ thuật này thường áp dụng trong trường hợp: 
  • Nhiều chức năng sử dụng các thành phần logic tương tự nhau nhưng các thành phần này không hoạt động cùng một thời điểm. 
  • Ưu tiên chia sẻ phần logic có tài nguyên lớn hơn. Trong một thiết kế, có thành phần dùng nhiều cổng logic, có thành phần dùng ít cổng logic hơn. Nếu không thể thực hiện phương pháp chia sẻ tài nguyên cho các thành phần này cùng lúc thì ưu tiên áp dụng cho phần tốn nhiều logic.
Ví dụ, một khối chức năng thực hiện nhân và cộng các giá trị 8 bit từ nhiều nguồn ngõ vào và chỉ đưa ra một kết quả tại một thời điểm. Khối này có thể được thiết kế dùng “2 bộ nhân, 2 bộ cộng và 1 MUX” hoặc “1 bộ nhân, 1 bộ cộng và 3 MUX”. Vì bộ nhân và bộ cộng 8 bit có tài nguyên lớn hơn MUX, nên cách “1 bộ nhân, 1 bộ cộng và 3 MUX” được lựa chọn để tối ưu tài nguyên hiệu quả.
Hình 18: Chia sẻ tài nguyên mạch logic bộ nhân và cộng
RTL code của cấu trúc dùng 2 bộ nhân và 2 bộ cộng:
always_comb begin
  if (Sel)
    MulOut = MulInA * MulInB + AddIn1;
  else
    MulOut = MulInC * MulInD + AddIn2;
end
RTL code của cấu trúc dùng 1 bộ nhân và 1 bộ cộng:
always_comb begin
  MulIn1 = Sel? MulInA: MulInC;
  MulIn2 = Sel? MulInB: MulInD;
  AddIn = Sel? AddIn1: AddIn2;
  MulOut = MulIn1 * MulIn2 + AddIn;
end
Kết quả tổng hợp trên cùng một linh kiện FPGA với Quartus II, số lượng phần tử logic khi dùng 1 bộ MUX là 257 trong khi dùng 3 bộ MUX là 142.
(a) Kết quả tổng hợp cho cấu trúc dùng 2 bộ nhân và 2 bộ cộng
(b) Kết quả tổng hợp cho cấu trúc dùng 1 bộ nhân và 1 bộ cộng
Hình 19: Kết quả tổng hợp ví dụ hình 18 trên FPGA
Một ví dụ khác, một FSM có 2 trạng thái:
  • PRE_DELAY: giữ trong 89 chu kỳ xung clock trước khi chuyển sang POST_DELAY
  • POST_DELAY: giữ trong 120 chu kỳ xung clock trước khi chuyển sang PRE_DELAY.
Trường hợp này, một bộ đếm 7 bit được dùng để đếm số chu kỳ ở mỗi trạng thái thay vì dùng hai bộ đếm, 1 bộ đếm 6 bit dùng cho PRE_DELAY và một bộ đếm 6 bit dùng cho POST_DELAY.
Hình 20: Chia sẻ tài nguyên bộ cộng
Về việc loại bỏ logic không sử dụng, trong một số trường hợp, nhiều logic được gán giá trị ngõ vào cố định nên ngõ ra không bao giờ thay đổi trạng thái trong suốt quá trình hoạt động. Phần logic này có thể được tối ưu bằng một trong hai cách: 
  • Xóa bỏ phần code không dùng trong các file RTL code
  • Giữ nguyên RTL code nhưng cho phép trình tổng hợp (compiler) tối ưu và xóa bỏ các logic không sử dụng 
Trên thực tế, việc xóa bỏ một phần code đôi khi không khả thi, đặc biệt là đối với các phần code phức tạp hoặc code được tái sử dụng từ dự án trước hoặc code được phát triển bởi bên thứ 3 (người khác, công ty khác), vì nó gây rủi ro về việc sinh ra bug và tốn thời gian để kiểm tra lại thiết kế. 
Việc cho phép trình tổng hợp xóa bỏ các logic không sử dụng hoàn toàn phụ thuộc vào chiến lược tối ưu và yêu cầu (rule) chung của khâu back-end. Nếu không có sự thảo luận giữa người thiết kế và người làm back-end, người thiết kế sẽ không biết chắc phần logic không sử dụng có được xóa bỏ hay không. 
5.3.2) Khả năng giảm công suất 
Việc tối ưu tài nguyên giúp loại bỏ và giảm bớt các phần tử tiêu thụ điện không cần thiết nên đương nhiên giúp giảm cả công suất tích cực và công suất do dòng rò. 
5.3.3) Mức thiết kế 
Mức thiết kế kiến trúc: 
  • Phân tích và lựa chọn cấu trúc, thuật toán 
  • Phân chia khối chức năng 
Mức thiết kế RTL:
  • Phân tích và tối ưu mạch logic 
Mức thiết kế vật lý: Cho phép tối ưu và xóa bỏ các thành phần logic không sử dụng, ví dụ như thành phần không bao giờ thay đổi giá trị, các thành phần logic cùng chức năng, …
Đối với kỹ thuật tối ưu tài nguyên thiết kế, một điểm quan trọng cần nắm rõ là trình tổng hợp chỉ có khả năng tối ưu trên cấu trúc logic được người thiết kế mô tả bằng RTL code chứ không có khả năng thay đổi cấu trúc hoặc chức năng logic hiện có thành cấu trúc hoàn toàn khác nhưng có thể thực hiện cùng chức năng. Bài viết về lõi IP AES-128 là một ví dụ, nếu bạn thiết kế S-BOX theo cách dùng MUX thì trình tổng hợp chỉ tối ưu mạch MUX nhưng bản chất vẫn là MUX chứ không thể chuyển tối ưu thành một phương pháp khác như cách biến đổi số học. Như vậy, khả năng tối ưu của một thiết kế phụ thuộc lớn vào thiết kế mức kiến trúc và RTL.
Hình 21: Quá trình tổng hợp RTL code thành gate netlist
Trong hình minh họa trên, việc tối ưu (optimization) của trình tổng hợp là dựa trên cấu trúc có sẵn mô tả bởi RTL chứ không phải thay đổi cấu trúc của mạch logic.
5.4) Clock gating 
5.4.1) Mô tả kỹ thuật 
Đây là một kỹ thuật phổ biến giúp giảm công suất động. Nguyên lý của kỹ thuật này là tắt nguồn clock trên các FF khi chúng không hoạt động hoặc không cần cập nhật giá trị mới. 
Trong thiết kế thông thường, một số lượng lớn các FF thường chỉ cập nhật giá trị mới trong một điều kiện nhất định. Vì vậy, khi FF không cập nhật giá trị mới, clock trên FF có thể được tắt. Lúc này, FF vẫn được cấp nguồn và giữ nguyên giá trị hiện tại. Kỹ thuật này thường được mô tả bằng mô hình thay thế đơn giản như hình minh họa sau đây.
Hình 22: Phương pháp clock gating
Tuy nhiên, hình trên chỉ mang ý nghĩa minh họa chứ không ứng dụng trong thực tế. Giả sử, en là tín hiệu đồng bộ theo cạnh lên clock clk và chỉ tích cực một chu kỳ, waveform của tín hiệu gated_clk có thể như sau.
Hình 23: Glitch có thể sinh ra trên ngõ ra của clock gating cell khi chỉ dùng một cổng AND đơn thuần
Trong waveform trên, khi en và clk được AND với nhau đơn thuần, ngõ ra cổng AND là gated_clk có thể xuất hiện cạnh lên không mong muốn làm ngõ ra Q cập nhật một giá trị không mong muốn. Bên cạnh đó, cạnh lên mong muốn chỉ là một glitch. Trên thực tế, cấu trúc của mạch logic tắt clock dùng thêm một Latch tích cực theo mức logic thấp của clock. Mạch nguyên lý này sẽ được đóng gói thành một cell chuẩn trong thư viện công nghệ gọi là ICGC (Integrated Clock Gating Cell). Cell này sẽ được chèn vào netlist trong quá trình tổng hợp.
Hình 24: Mô hình một ICGC dùng Latch và AND
Theo hình minh họa trên đây, Latch nhạy theo mức, tích cực theo mức thấp clk. Khi clk mức thấp, Latch sẽ bắt giá trị của tín hiệu en và tạo ra tín hiệu latched_en tích cực theo cạnh xuống clk. Tín hiệu này khi AND với clock sẽ tạo ra được gated_clk có cạnh lên và độ rộng xung như mong muốn. 
5.4.2) Khả năng giảm công suất 
Clock gating giúp giảm công suất động vì nó ngăn việc chuyển mức logic của clock tác động đến FF. 
5.4.3) Mức thiết kế 
Thiết kế cấu trúc: Quyết định cơ chế và phương pháp áp dụng clock gating mức khối. Một cách tổng quan, mức thiết kế này quyết định khi nào một khối được cấp clock. Điều này có thể được thực hiện bằng nhiều cách: 
  • Dùng một khối độc lập để quản lý các nguồn clock 
  • Tích hợp phần logic quản lý nguồn clock vào chung với khối tạo clock của chip 
Mỗi khối chức năng có chứa phần logic quản lý nguồn clock riêng Chức năng chung của phần logic quản lý nguồn clock là tạo ra tín hiệu cho phép (enable). Tín hiệu này chỉ tích cực để cho phép cấp clock đến một khối trong những điều kiện hoạt động nhất định.
Hình 25: Quản lý tắt/mở clock cho từng khối chức năng
Trong hình minh họa trên đây, khối clock management tạo ra các tín hiệu cho phép clk_enA/B/C để quyết định khi nào cho phép clock clk được cấp cho khối A/B/C. 
Thiết kế RTL: Thiết các phần logic quản lý nguồn clock và thực hiện việc chèn các clock gating cell (ICGC) ở những vị trí đã được chỉ định từ mức thiết kế kiến trúc. Việc chèn ICGC chỉ đơn giản là chọn ICGC phù hợp từ thư viện công nghệ và kết nối chúng trong RTL code. Ví dụ, ICGC sau đây được chọn để sử dụng.
Hình 26: Một ICGC cell từ thư viện công nghệ
ICGC này có hai tín hiệu cho phép là TE và E. TE là Test Enable, đây là chân cho phép clock dùng trong chế độ test (chế độ DFT). E là Enable, đây là chân cho phép clock trong chế độ hoạt động thông thường. Một trong hai tín hiệu này bằng 1 thì Q sẽ được nối đến CK. Giả sử, thiết kế không dùng chế độ test. Các ICGC trong hình 25 được thực hiện trong RTL code như sau: 
GCKES ICGCA (.TE(1’b1), .E(clk_enA), .CK(clk), .Q(gated_clkA));
GCKES ICGCB (.TE(1’b1), .E(clk_enB), .CK(clk), .Q(gated_clkB));
GCKES ICGCC (.TE(1’b1), .E(clk_enC), .CK(clk), .Q(gated_clkC));
GCKES ICGCD (.TE(1’b1), .E(clk_enD), .CK(clk), .Q(gated_clkD)); 
Nó đơn giản chỉ là cách instance một module. 
Vấn đề của cách làm này là khi mô phỏng mức RTL code, trình mô phỏng không hiểu các thành phần của thư viện tổng hợp nên các cell này sẽ dùng một mô hình tương đương mức RTL như sau: 
module GCKES (
  input logic TE,
  input logic E,
  input logic CK,
  output logic Q
  );
logic qLatch;
always_latch begin
  if (~CK)
    qLatch <= TE | E;
end
assign Q = qLatch & CK;
endmodule
Đối với từng mạch tuần tự dùng FF bên trong các khối, chúng cần được thiết kế và viết RTL code theo mô hình “có thể chèn clock gating cell” chứ không trực tiếp chèn các clock gating cell.
Hình 27: Mô tả RTL code theo dạng có thể chèn được clock gating cell
Thiết kế vật lý: Thực hiện chèn clock gating cell tại những mạch tuần tự “có thể chèn clock gating cell” đã mô tả trong RTL code.
5.5) Power gating
5.5.1) Mô tả kỹ thuật

Power gating là kỹ thuật tắt nguồn các phần tử logic không sử dụng trong một vi mạch. Kỹ thuật này giúp giảm công suất tiêu thụ trên các mạch logic một cách triệt để nhất nhưng việc thực hiện nhiều phức tạp hơn các kỹ thuật khác.
Để ngắt nguồn một thành phần logic, các PMOS có điện áp ngưỡng cao được mắc giữa nguồn Vdd và thành phần logic, NMOS có điện áp ngưỡng cao được mắc giữa đất Vss và thành phần logic. Điều khiển tắt/mở các CMOS này sẽ giúp tắt/mở nguồn thành phần logic. Trong thực tế, việc ngắt nguồn có thể chỉ cần dùng PMOS mắc giữa nguồn Vdd và thành phần logic hoặc chỉ dùng NMOS hoặc dùng cả hai.
Hình 28: Kỹ thuật power gating
Hai vấn đề quan trọng cần phải giải quyết khi áp dụng kỹ thuật này là: 
  • Phần được ngắt nguồn không ảnh hưởng đến hoạt động của các khối khác 
  • Trong một số trường hợp, hệ thống phải hoạt động trở lại ở trạng thái mong muốn sau khi cấp nguồn lại cho các phần tử bị ngắt mà không phải khởi tạo lại toàn bộ hệ thống. 
Trong một chip, các thành phần logic có kết nối với nhau qua các input và output. Việc ngắt nguồn một thành phần nào đó làm cho các tín hiệu output của nó không được lái một mức logic xác định. Điều này làm hoạt động của các khối khác bị sai hoặc không thể hoạt động. Vì vậy, cần phải có một thành phần duy trì mức logic xác định, 0 hoặc 1, trên ngõ ra của các phần tử bị ngắt nguồn. Thành phần này gọi là các khối cách ly (isolation block, isolation cell). Isolation cell có thể là một trong các loại sau: 
  • Loại clamp 1: giữ ngõ ra của cell mức 1 
  • Loại clamp 0: giữ ngõ ra của cell mức 0
  • Loại Latch: giữ lại mức logic trước khi ngắt nguồn để lái đến ngõ ra của cell
Hình 29: Chèn isolation cell trên các tín hiệu ngõ ra của khối được ngắt nguồn
Một cấu trúc loại Latch của isolation cell của AMCC được thể hiện dưới đây.
HÌnh 30: Một cấu trúc isolation cell loại Latch (đây là đăng ký sáng chế của AMCC, xem thêm ở phần tài liệu tham khảo)
Trong một số chế độ tiết kiệm năng lượng, thành phần được ngắt nguồn phải khôi phục lại trạng thái hoạt động tối thiểu sau khi được cấp nguồn trở lại mà không phải khởi tạo lại toàn bộ hệ thống. Muốn thực hiện được điều này, trước khi ngắt nguồn, các trạng thái hoạt động tối thiểu phải được lưu lại trong một thành phần nào đó. Tất nhiên, thành phần này luôn được cấp nguồn.
Hình 31: Trình tự hoạt động của quá trình ngắt và cấp nguồn lại một khối chức năng khi cần khôi phục lại trạng thái ban đầu
5.5.2) Khả năng giảm công suất 
Power gating là kỹ thuật không chỉ giúp loại bỏ công suất động mà còn giảm công suất dòng rò hiệu quả vì các phần tử tiêu thụ điện không được cấp nguồn. 
5.5.3) Mức thiết kế 
Mức thiết kế kiến trúc: 
  • Xây dựng các chế độ tiết kiệm năng lượng tiêu thụ, ví dụ như chế độ standby, chế độ sleep, chế độ deep sleep, … 
  • Quyết định khối logic nào được ngắt nguồn trong từng chế độ tiết kiệm năng lượng 
  • Xây dựng cơ chế và trình tự ngắn nguồn các khối. 
Mức thiết kế RTL: Thiết kế mạch logic chi tiết điều khiển quá trình ngắt nguồn và cấp nguồn cho từng khối logic 
Mức thiết kế vật lý: Thực hiện chèn các isolation cell giữa miền có thể bị ngắt nguồn và các miền khác. 
5.6) Một số kỹ thuật khác 
Các kỹ thuật này được thực hiện chủ yếu ở mức thiết kế vật lý và mức công nghệ chế tạo nên chỉ được nêu ngắn gọn với mục đích tham khảo 
5.6.1) Phân chia miền điện áp (multi voltage hoặc multi power domain) 
Kỹ thuật này thực hiện cung cấp điện áp khác nhau cho các thành phần logic. Điện áp cao chỉ cấp cho các miền cần tấn số xử lý cao. Các miền sử dụng tần số thấp hơn có thể được cấp điện áp thấp hơn sẽ giúp giảm đáng kể công tích cực. Lưu ý, việc giảm điện áp sẽ làm tăng độ trễ lan truyền (propagation delay) trên các cell. Nghĩa là tần số xử lý sẽ bị giảm. Điều này thể hiện qua công thức tính độ trễ làn truyền trên một cell như sau:
Trong đó:
  • Vdd là điện áp nguồn
  • Vt là điện áp ngưỡng
Bên cạnh đó, khi một chip có nhiều miền điện áp khác nhau, các tín hiệu kết nối giữa các miền cần phải chèn thêm một thành phần giúp chúng hiểu đúng mức logic của nhau. Thành phần này gọi là bộ dịch mức (level shifter, logic-level shifter hoặc voltage level translations).
Hình 32: Kỹ thuật phân chia đa miền điện áp
5.6.2) Sử dụng nhiều mức điện áp ngưỡng (Multi threshold)
Kỹ thuật sử dụng các cell có mức điện áp ngưỡng khác nhau để giảm công suất dòng rò sub-threshold. Có hai cách thực hiện: 
  • Sử dụng các cell có mức điện áp ngưỡng khác nhau nhưng điện áp ngưỡng cấp cho các cell là cố định. 
  • Sử dụng các cell điều chỉnh được mức điện áp ngưỡng.
Tùy vào chế độ hoạt động, điện áp ngưỡng trên các cell này sẽ được điều chỉnh phù hợp. Cell có điện áp ngưỡng thấp sẽ có độ trễ thấp nhưng dòng rò lớn. Cell có điện áp ngưỡng cao sẽ có độ trễ cao nhưng dòng rò thấp. Việc kết hợp các loại cell có mức điện áp ngưỡng khác nhau (có thể lựa chọn khi tổng hợp, sẽ giúp cân bằng giữa công suất tiêu tiêu thụ và tốc độ xử lý của mạch logic. Ví dụ, các LVT cell (Low Vt) sẽ được dùng trên các đường yêu cầu nghiêm ngặt về timing (timing critical path), đòi hỏi độ trễ thấp.
Hình 33: Sử dụng các cell có điện áp ngưỡng khác nhau (từ tài liệu tham khảo)
Để thực hiện được kỹ thuật điều chỉnh điện áp ngưỡng, thư viện công nghệ phải hỗ trợ các cell cho phép điều khiển điện áp phân cực trên cực nền (substrate). Các cell này được cấu tạo từ các CMOS có điện áp ngưỡng biến thiên (VTCMOS – Variable Threshold CMOS).
Hình 34: (a) CMOS thông thường (b) VTCMOS (c) Sử dụng VTCMOS
Trên đây là một số kỹ thuật giúp giảm công suất tiêu thụ trong một vi mạch. Nội dung trình bày hướng đến việc giải thích các khái niệm cơ bản giúp bạn đọc hiểu kỹ thuật đó là gì? thực hiện như thế nào? và vì sao nó có thể giúp giảm công suất tiêu thụ? Nếu có nội dung chưa rõ hoặc chưa chính xác, mong bạn đọc góp ý dưới bài viết để tác giả chỉnh sửa.

Tài liệu tham khảo:
1) Texas Instruments; CMOS Power Consumption and Cpd Calculation; June 1997;
2) R. Saleh ; Leakage and Low-Power Design; Dept. of ECE, University of British Columbia
3) Mahdi Shabany; ASIC/FPGA Chip Design, Verilog for Synthesis; Department of Electrical Engineering, Sharif University of technology
4) EDN; Low power design techniques; July 24 2012
5) TrueChip; Low Power Design Techniques - Basics Concepts In Chip Design
6) EDN; Reducing IC power consumption: Low-power design techniques; September 24 2015
7) Anjan Rudra; MULTISTAGE LATCH-BASED ISOLATION CELL; US 8,575,984 B1, United States Patent; Nov. 5, 2013
8) Intel; Enhanced Intel® SpeedStep® Technology for the Intel® Pentium® M Processor; March 2004
9) Semiconductor Engineering; Multi-Vt

Lịch sử cập nhật:
1) 2020.03.01 - Tạo lần đầu